
抽取式摘要直接挑选原文中的句子,保留原句措辞和先后顺序,适合需要回到原文核对的材料。这个工具会同时运行 TextRank 和 LexRank:两种方法分别给句子排序,再按设定的长度选句。下文用一篇虚构的社区图书馆短文,展示如何设置长度并比较两份摘要。
01
从句子相似度到两份摘要
分析单位是一句有效文本。TATOOLS 先切句、分词,用 TF-IDF 表示每句的词语特征,再计算句子之间的相似度。TextRank 把句子看成相连的节点,按相互关联程度迭代排序;LexRank 先滤掉相似度较低的连接,再寻找在句子网络中更居中的句子。两者各自取分数最高的若干句,最后按原文顺序排回摘要。
这些权重只用于同一篇文章内部选句:一篇材料里的高权重句,不因此比另一篇材料里的句子更重要。两种方法都依赖可识别的句子边界和句间用词关联。原文若有大量断裂短句,先整理标点与段落,再看抽取结果更容易核对。
02
从任务页指定摘要长度
打开 抽取式摘要 上传文档。页面支持按压缩比或目标句数控制长度,并可自动判断文本语言,也可指定中文或英文。截图展示当前默认任务页。
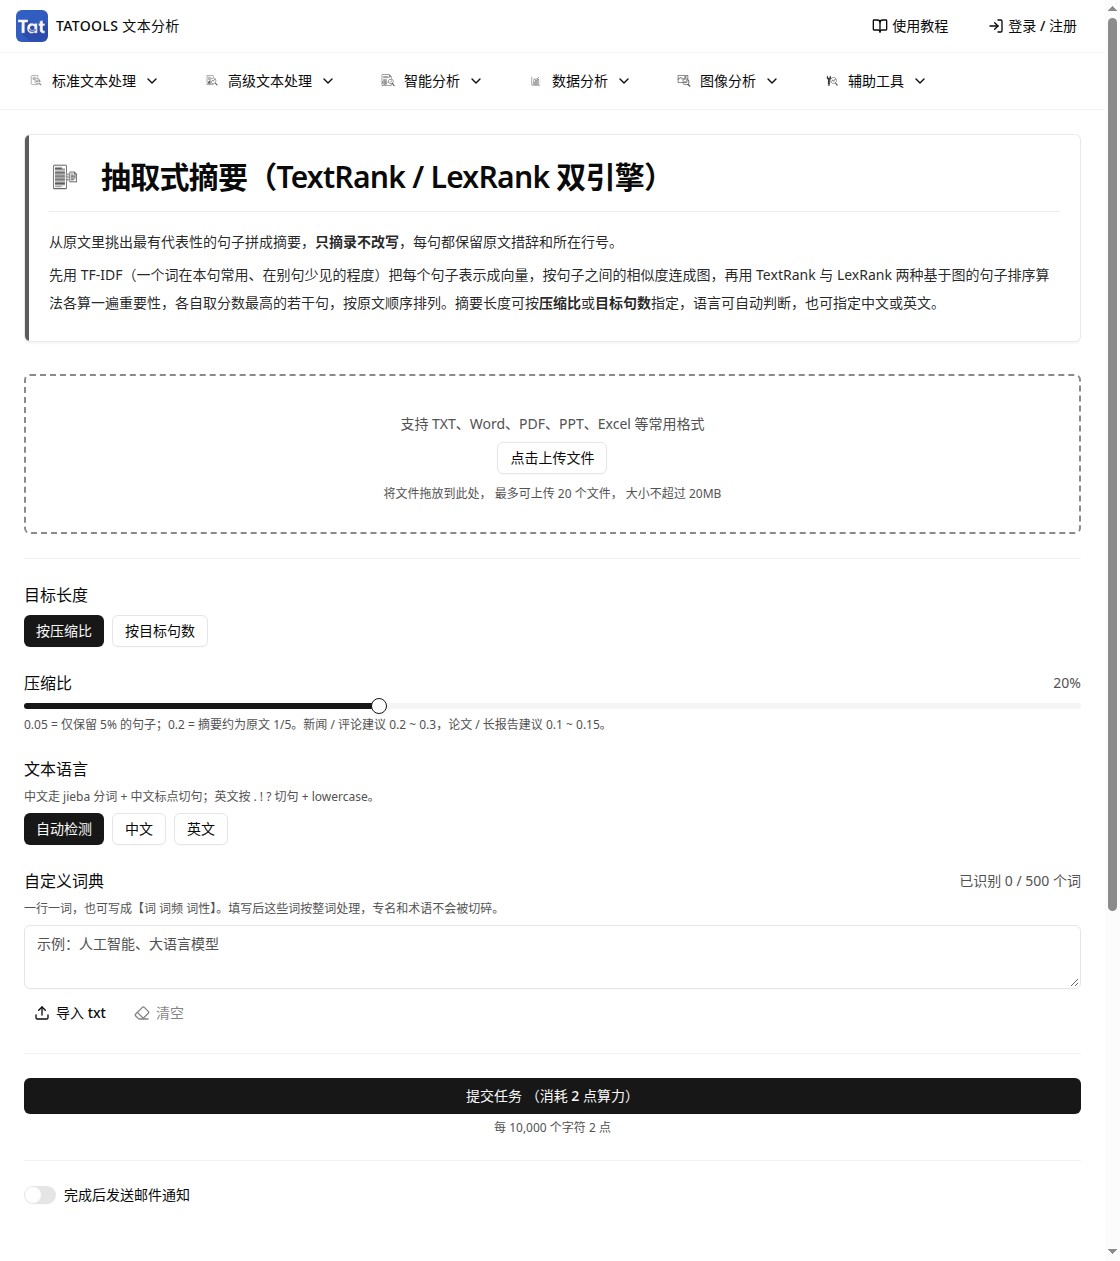
抽取式摘要任务页:上传文档、选择压缩比或目标句数与语言
本次上传一篇虚构短文,内容是社区图书馆调整周末开放安排的过程。
保留【按压缩比】和默认的 20%,语言保持【自动检测】。如果需要固定篇幅,可以改用【按目标句数】。
提交任务后,先看原文句数与实际摘要句数,再对照两种算法选中的原句。
压缩比控制的是保留句子的目标比例。原文切句后的数量会影响最终取整,因此报告中的实际比例可能与设置值略有差异。
例如 19 句乘以 20% 得到 3.8 句,TATOOLS 在本次报告里取为 4 句;实际压缩比便是 4 ÷ 19,约 21.1%。按目标句数时,设置值直接决定每种算法最多取几句,但不会超过可用句数。
03
报告中的 19 句与 4 句
这篇示例短文被切成 19 句。报告显示 TextRank 和 LexRank 各选出 4 句,实际压缩比为 21.1%;两种方法有 3 句相同,重合度为 75%。
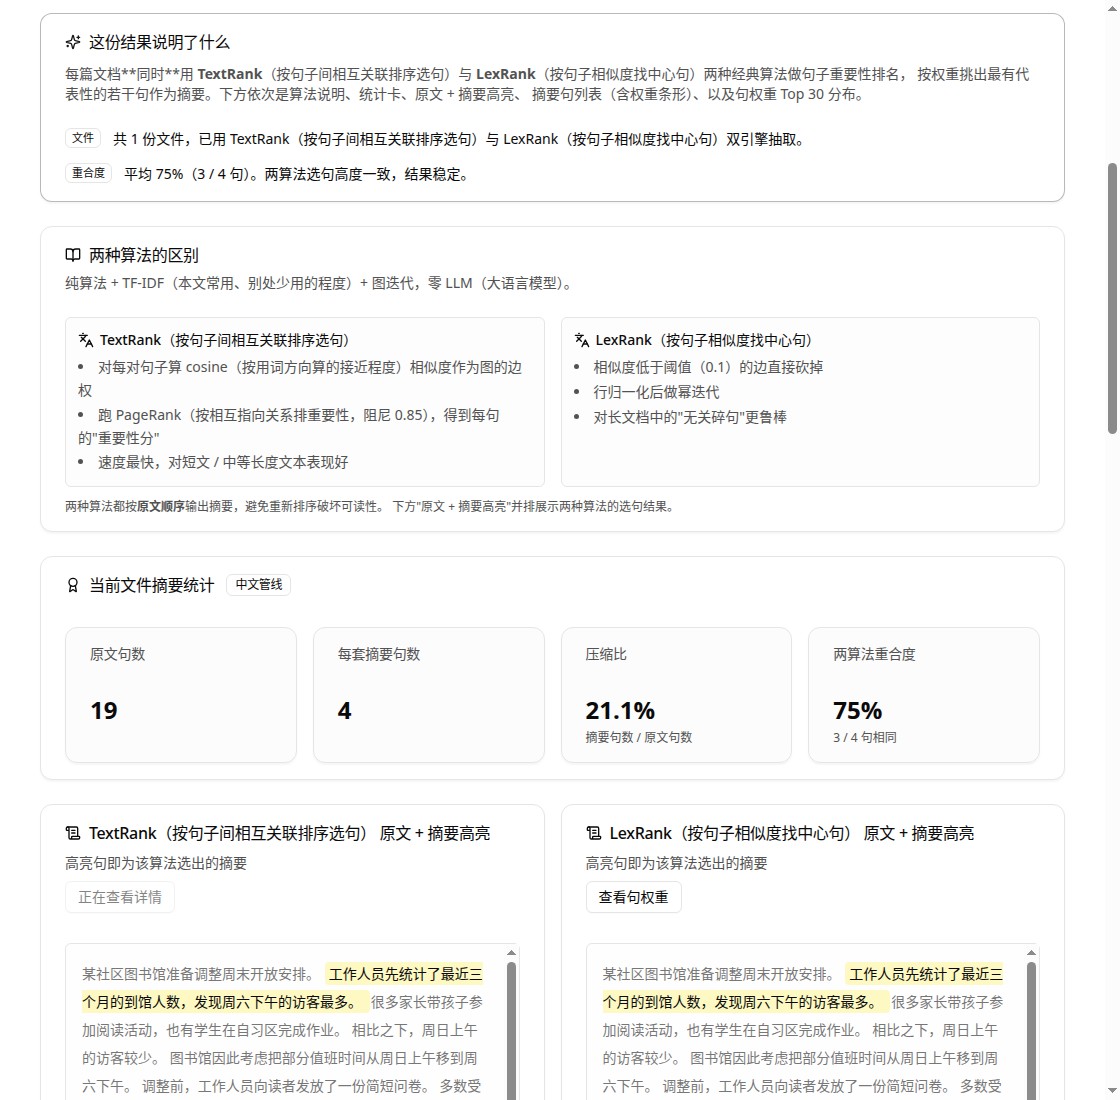
社区图书馆示例的抽取式摘要报告:原文 19 句、每种方法选 4 句、重合 3 句
向下看【原文 + 摘要高亮】,被选中的句子仍在原文位置。TextRank 的选句包括【工作人员先统计了最近三个月的到馆人数,发现周六下午的访客最多】和【试行期间,周六下午的借阅次数增加,周日上午的借阅次数变化不大】。它们分别交代调整依据和试行结果;读者可以直接核对前后语境。
75% 表示这一次两套四句摘要有三句重合,只描述两种算法在这篇材料上的选句一致程度。对于需要保留的关键事实,还应查看未入选的句子,并按写作目的决定是否调整摘要长度或手工补充。
04
什么时候选压缩比或句数
批量处理篇幅不同的文章时,压缩比让摘要长度随原文变化;需要每份材料都提供相同数量的摘录时,选目标句数。两种模式都只从原文取句。如果需要一段重新组织语言的摘要,应另行撰写或使用生成式方法,并与原文核对。
小结:
TATOOLS 的两套结果都取自原句,并按原文顺序展示。
压缩比与实际句数要一起读;本例设置 20%,实际为 4 ÷ 19=21.1%。
用原文高亮核对选句,用 3 ÷ 4=75% 的重合度观察两种方法在本篇的选句交集;后续可接文本可读性分析检查摘录面向的读者。
END