使用教程
学习如何使用各项功能,快速上手
 文本分析基础教程主题模型LDA
LDA 主题模型完整教程:从生成过程与狄利克雷先验,到自动定主题数和三种向量化方式
三十份城市更新办法,一个省各地市的国土空间规划,怎样看清它们反复在讲哪几类事情?这篇教程从 LDA 的生成过程讲起,说明一段话怎样被看成几个主题按比例混合写成,α 和 β 两个狄利克雷先验分别管什么,模型又怎样用变分贝叶斯从词语共现里估出主题。接着讲 TATOOLS 怎样把每个文件切成片段、筛出进入模型的词,自动定主题数时怎样先排除退化主题再比较一致性,以及词袋、语义向量和 Word2Vec 三种向量化方式各自怎样建立词和词的关系。后半部分逐项讲报告,从主题标签和代表性原文,到占比与平均权重的区别,再到一致性、PMI 和困惑度这几项指标各量什么,每一项都配公式和可以手算的例子。最后给出论文方法部分的写法示例。
 文本分析基础教程情感分析开源模型
Mia 开源情感分析:逐条看出是夸、是骂,还是说不上夸骂
Mia 是 TATOOLS 训练并开源的中文情感模型,逐条判断每句话是在夸、在骂,还是说不上夸骂。这篇教程介绍它公开了哪些内容和公开测试成绩,讲清每条得到的三个数、把握和整批比例的分母,并用公开实例演示任务页设置与报告阅读。
 文本分析基础教程知识图谱网络分析
知识图谱抽取教程(下):网络指标、主题板块与追问系统
下篇讲怎样在图上得出结论:密度、平均度、聚类系数、连通分量、路径长度与直径的公式与读法,三种中心性与 Freeman 中心势,Leiden 社区发现与模块度,推理链与实体速查,深度分析卡与自动文字,追问系统的三层索引与一次提问的四步,以及版本、导出与论文写法。
 文本分析基础教程知识图谱实体关系抽取
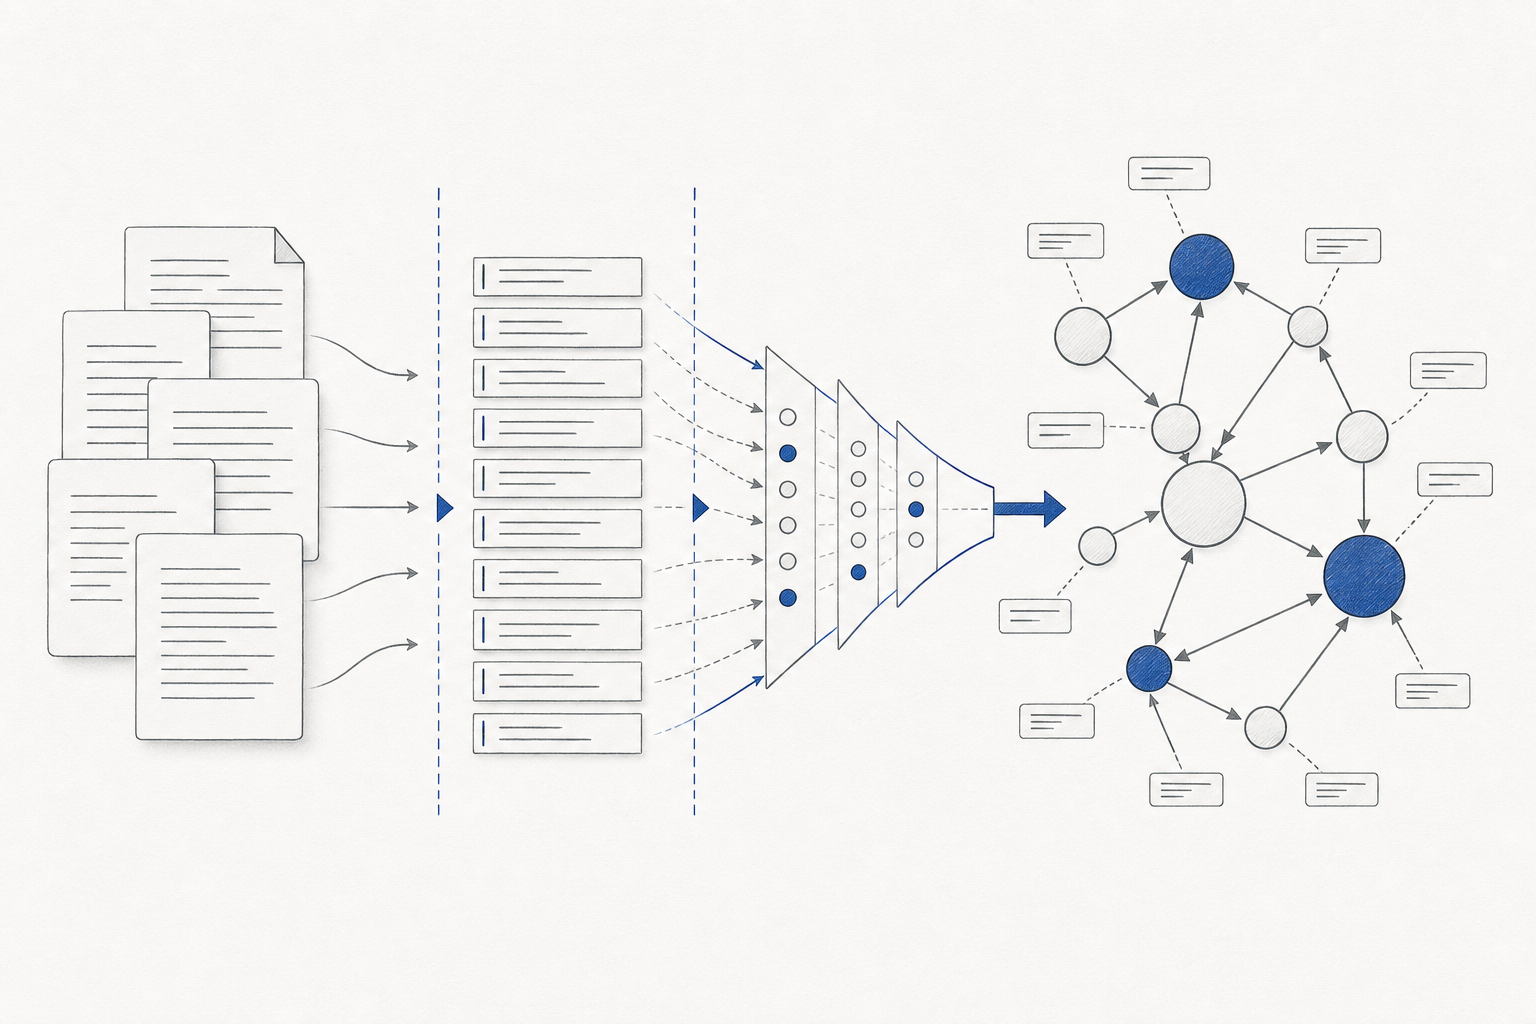
知识图谱抽取教程(上):从文本到可回溯证据的关系网络
上篇讲一张知识图谱怎样从文本中建立起来:三元组为什么是分析单位,本体与五种抽取框架怎样定义研究视角,两阶段抽取与上下文窗口怎样工作,证据锚定怎样让结果可审计,实体消解与谓词归一怎样归并,有向多重图与无向简单图两种口径怎样换算,结构角色与置信度从何而来,多份材料怎样合成一张图,以及基础报告与导出表格怎样读。
 文本分析基础教程敏感信息脱敏个人信息
敏感信息脱敏:批量替换固定格式的个人信息
以虚构电话、邮箱和测试 IP 为例,介绍脱敏类型与占位符设置,核对已完成报告中的替换文本,并说明命中明细仍保留原值。
 文本分析基础教程抽取式摘要TextRank
抽取式摘要:用 TextRank 和 LexRank 从原文选句
以虚构社区图书馆短文为例,展示抽取式摘要的长度设置、双算法选句、原文高亮与重合度的读法;附真实任务页和报告截图。
 文本分析基础教程词汇等级HSK
词汇等级评估:看整篇难度,也找出词表外的词
以虚构社区图书馆短文的实测报告为例,讲解 HSK 词表选择、整体等级的 90% 累计口径、词表覆盖率与未分级词的区别,并展示任务页和报告页。
 文本分析基础教程逐行情感情感分布
DeepSentiV2 情感分析教程:按语境判断整句倾向
DeepSentiV2 用整句语义而不是单个褒贬词判断情感。每条有效文本会得到积极、中性或消极标签、0 到 1 的得分,以及最多五个关键词。工具还提供七种行业文本类型,让同一句表达放回更贴近业务的语境中分析。下面从文本粒度、参数选择、报告阅读和两组实测样本说明具体用法。
 文本分析基础教程文本质量评估语料预处理
文本质量评估器:从字符构成到任务适用性,给语料做一次全面体检
你手头有一份文本,想拿去做主题建模或者情感分析,但不确定质量够不够。符号太多会不会让分词崩?重复行太多会不会让主题模型全是噪声?文本质量评估器帮你回答这些问题。它用纯统计方法(不调用大模型)从字符构成、词汇丰富度、重复率、句长分布、信息熵等多个维度给文本做一次量化体检,输出一份 0-100 的综合得分和六种 NLP 任务的适用性判定。
 文本分析基础教程关键词抽取文本分析
关键词抽取工具使用教程:TF-IDF 和 TextRank 双算法交叉验证,提取文本核心关键词
一篇文章里哪些词最能代表它的主题?单靠一种算法可能会有偏差。关键词抽取同时运行 TF-IDF 和 TextRank 两种方法,TF-IDF 看稀有度,TextRank 看关联强度,再自动计算排名相关系数,帮你在交叉验证中找到最可靠的关键词。
 文本分析基础教程词性标注语法分析
词性标注工具使用教程:统计词类分布,分析文本语法特征
文本中的名词、动词、形容词比例,会影响我们对文体风格的判断。词性标注会把每个词归入语法类别,再汇总为分布统计、相邻词性转移矩阵和基准语料对比。中文文本同时跑两套标注引擎,结果可以相互参照,帮助发现分词路径和语法角色判断上的差异;英文走句法级路径,标签集更贴近跨语言语法体系。
 文本分析基础教程文本规范化文本清洗
中文文本规范化工具使用教程:繁简转换、标点统一、数字转正文、拼音转写
不同来源的中文文本,繁简体、标点符号、数字写法经常不一致。人工阅读时不太显眼,但做排版发布或者文本分析时会出问题——同一个词在简体和繁体里变成了两个词条,词频统计就散了。中文文本规范化帮你把这些不一致统一起来,处理方式是无损替换,一个字都不会丢。和文本清洗不同,规范化是"改写",清洗是"删减",建议先规范化再清洗。
 文本清洗文本分析基础教程语料预处理
文本清洗工具使用教程:批量去除噪声、标点、停用词,输出干净语料
原始文本里经常混着 HTML 标签、多余标点、emoji、零宽字符这些东西。它们会干扰词频统计、主题建模、情感分析的结果。文本清洗帮你把这些噪声批量去掉,处理完得到干净文本和一份对照预览,方便你确认没有误删。
 文本分析基础教程情感分析情绪弧线
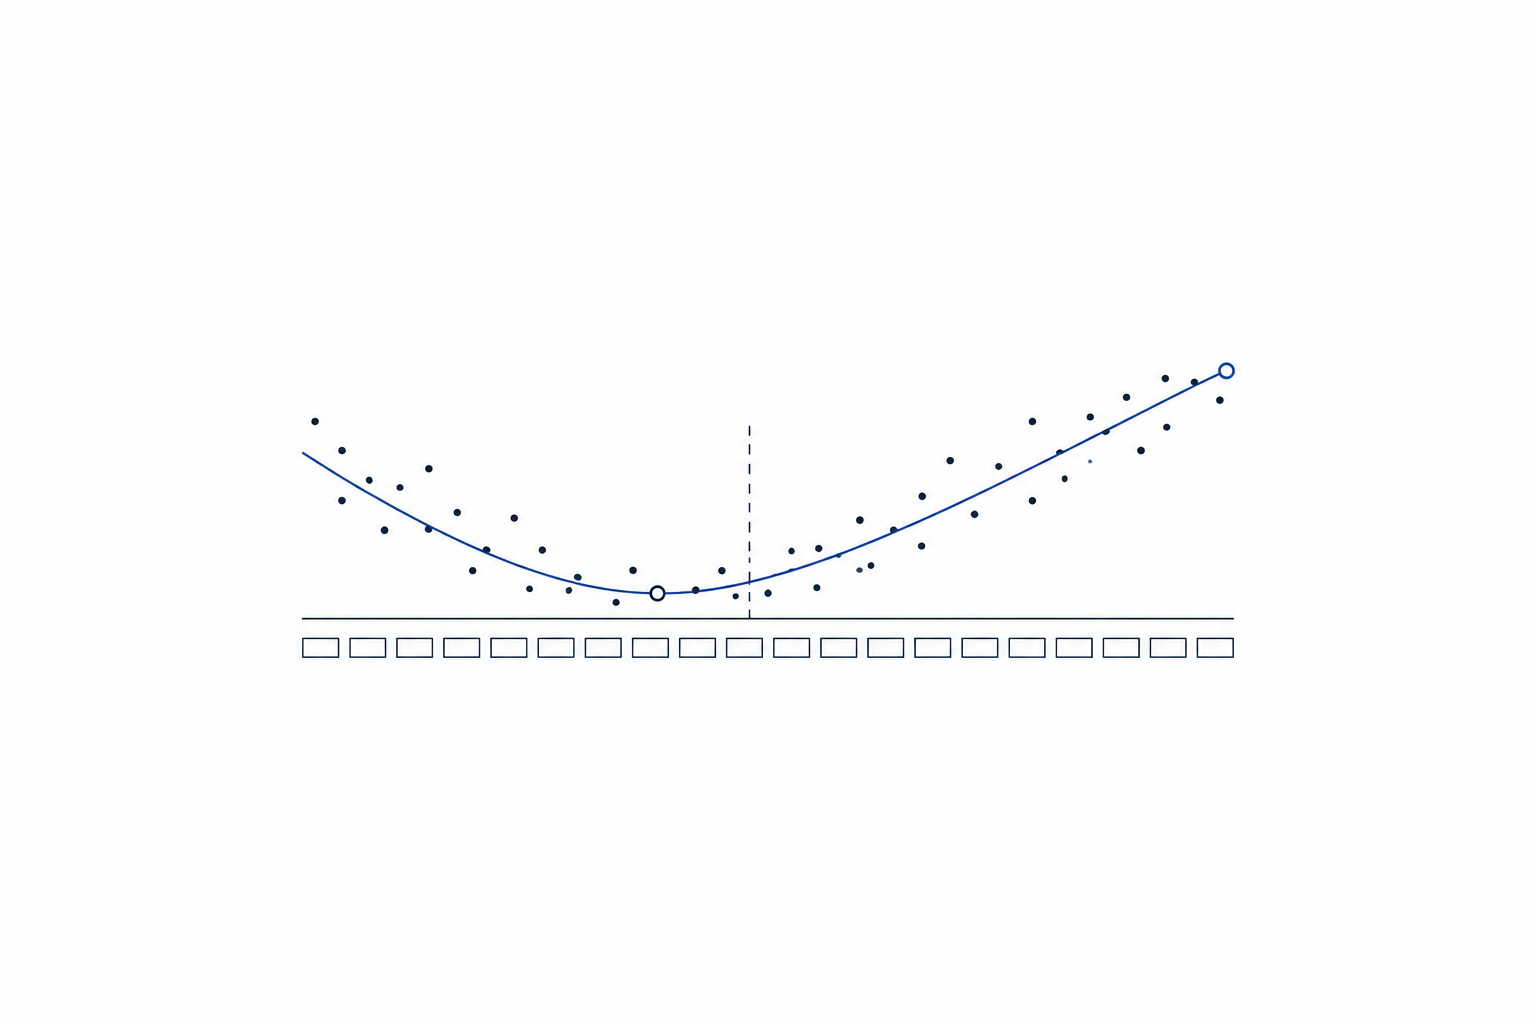
全文情感曲线完整教程:从效价与唤醒度,到分段打分、曲线平滑与转折点,再到六种经典情绪弧
一部长篇小说的情绪在哪里跌到谷底,又在哪里回升?这篇教程从 Russell 的效价与唤醒度和 Plutchik 的基本情绪讲起,说明 TATOOLS 的【全文情感曲线】怎样把长文本按章节和自然段切成连续片段,逐段判断情绪并摘录原文证据,在起落剧烈处拆回段落重判。文中手算片段长度、相邻片段的分差、PELT 变点检测的惩罚与切分,以及曲线和先抑后扬模板的相关系数 0.99,讲清离散余弦变换平滑和六种经典情绪弧。最后讲报告的阅读顺序和论文方法部分的写法。
 文本分析基础教程文本简化访谈转写
中文文本简化完整教程:从冗余与口语特征,到整理切段、逐段简化与数字核对,再到原文对照
访谈转写稿满篇口头语和重复,怎样整理成精炼的书面文字?这篇教程从口语不流畅现象讲起,说明 TATOOLS 的【中文文本简化】怎样先整理空白和被硬换行断开的句子,给缺标点的长行补标点,再按行或按空行切段,逐段交给中文文本简化模型删去口头语、重复和多余修饰。文中用一句访谈转写演示简化比例 50% 的算法,用一个例子讲清数字核对怎样找出简化后丢掉的数字,并讲清对照表各栏怎样读。最后讲简化版本怎样用于通读和编码,引用原话时为什么要回到原文。
共 59 篇教程,第 1 / 4 页