
准备教学材料或分级读物时,光看篇幅很难知道用词是否超出读者的词汇范围。词汇等级评估会把文本切成词,对照中文 HSK 或英文 CEFR、Oxford 词表,给出各等级的词次分布、整篇等级和未分级词。下文用一篇虚构的社区图书馆短文,展示从任务页到报告的读法。
01
分析单位是词次,整篇等级来自累计覆盖
词次指一个词在正文中出现一次。同一个词出现三次,就贡献三个词次;【不同词】只计一次。TATOOLS 先分词,再给能在所选词表中查到的词标等级。词表覆盖率的分母是全部词次:若 10 个词次中有 8 个查到等级,覆盖率就是 8 ÷ 10=80%。没有查到的词单列为【未分级词】,不会被强行判为最高等级。
整篇等级采用另一分母:已分级词次。从最低等级逐级累加,第一次覆盖至少 90% 已分级词次的等级,就是整篇等级。举个便于手算的例子:已分级词次共 10 个,低级词 7 次、中级词 2 次、高级词 1 次;累加到中级达到 9 ÷ 10=90%,整篇就定为中级。这个判定描述的是普通词汇分布。分词边界和词表范围会改变结果,报告里的未分级词需要回原文检查。
02
上传材料并选定评估口径
打开 词汇等级评估 上传文档。任务页可以自动判断语言,也可以手动指定中文或英文;中文可选 HSK 九级新标准或旧六级,英文可选 CEFR 或 Oxford。下图为当前页面的默认设置。
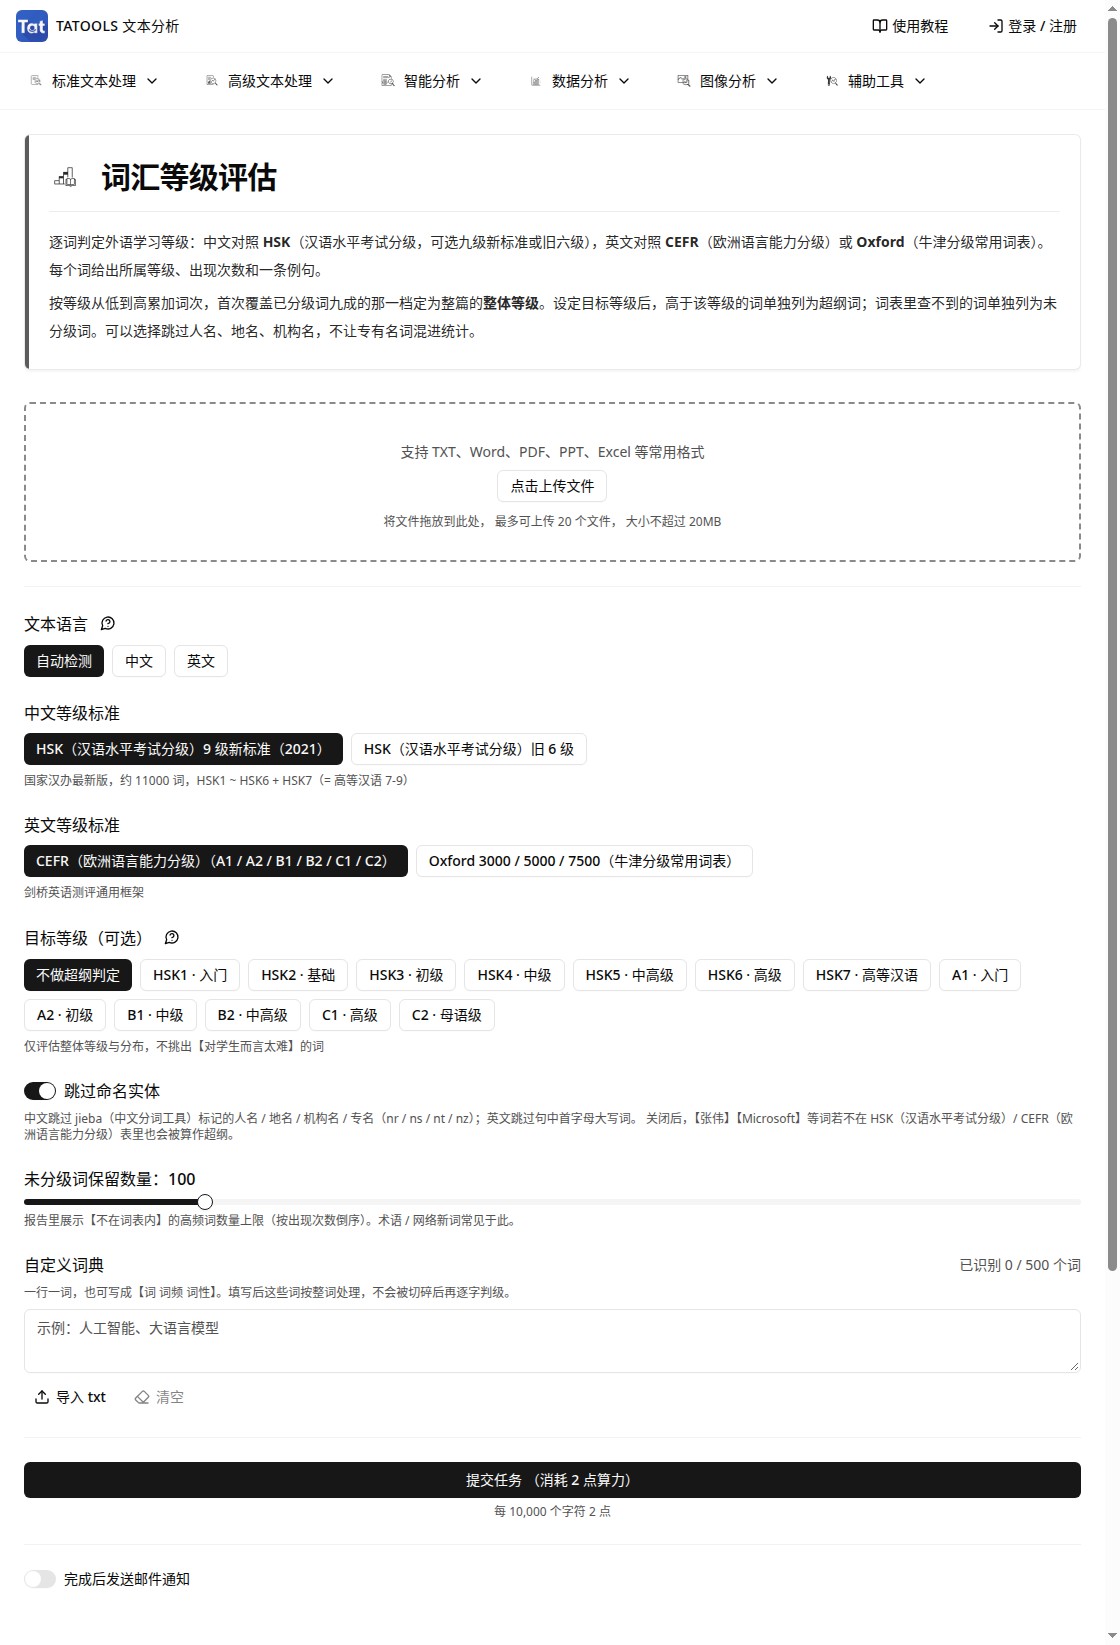
词汇等级评估任务页:语言、词表标准、目标等级和命名实体设置
先按材料语言选择词表。本次示例使用中文和 HSK 九级新标准,保留默认的【自动检测】。
如果要找出超过某个教学目标的词,再设置【目标等级】。本次没有设置,先观察整体等级。
按需决定是否跳过命名实体,以及【未分级词保留数量】。本次保持默认设置,上传文档后提交任务。
这些选项对应不同问题:整篇等级描述已分级词的总体分布;目标等级用于筛出超纲词;未分级词是没有在所选词表中查到的词,需单独核对。
03
用已完成报告读懂三个数字
示例短文讲述社区图书馆的阅读活动和借阅安排。报告统计了 165 个词次、120 个不同词,其中 146 个词次查到 HSK 等级,词表覆盖率为 88.5%;另有 19 个词次进入未分级词。报告把整篇判为 HSK4。
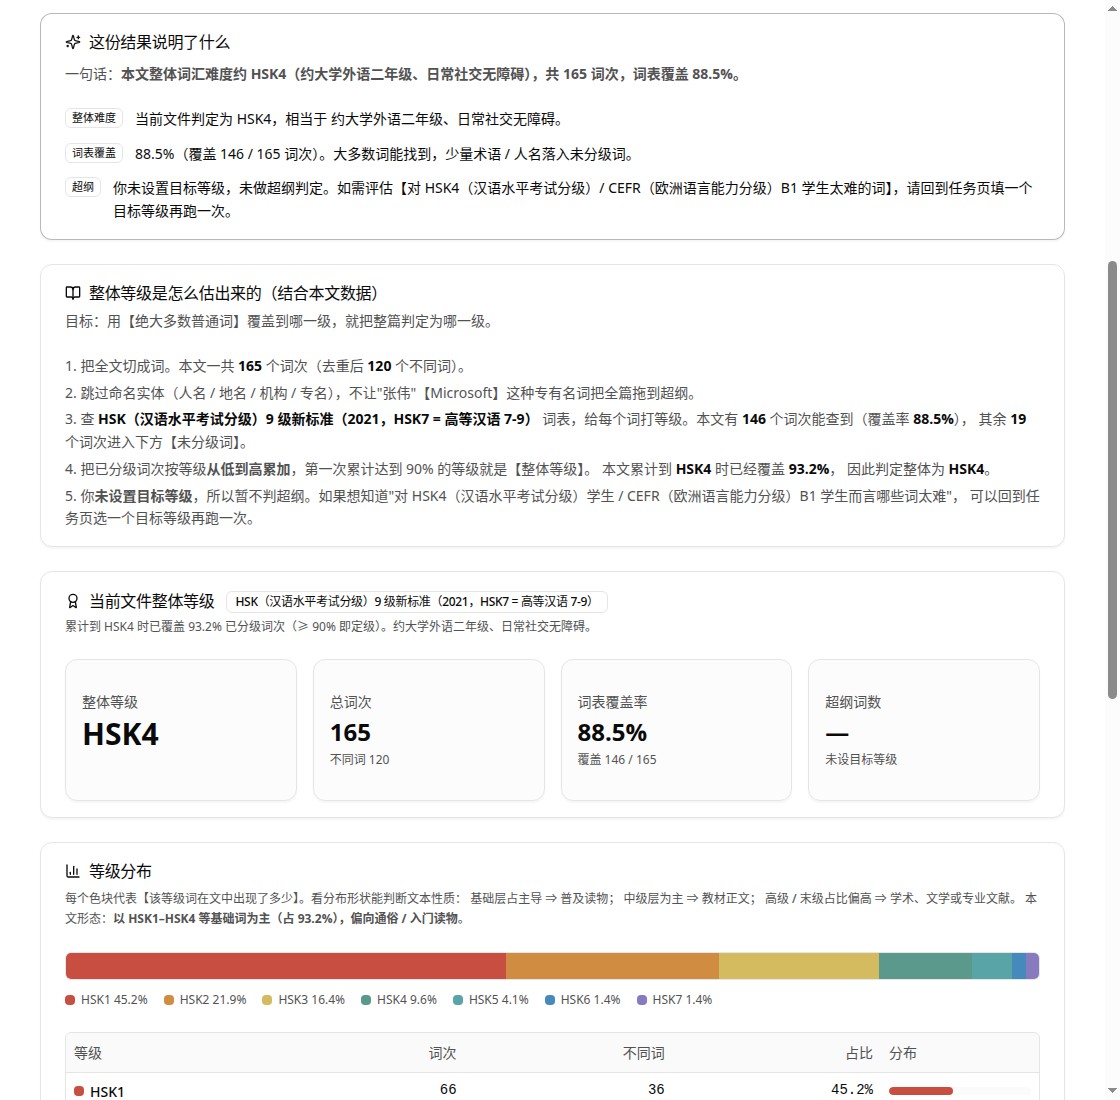
社区图书馆示例的词汇等级报告:165 词次、覆盖率 88.5%、整体等级 HSK4
整篇等级按已分级词次从低到高累加确定。示例累计到 HSK4 时覆盖了已分级词次的 93.2%,首次达到报告采用的 90% 门槛,因此显示 HSK4。88.5% 则是词表覆盖率,分母是全部 165 个词次;两项百分比回答的问题不同。
本次没有设置目标等级,报告中的【超纲词数】显示横线。若想检查面向 HSK3 读者的材料,应在任务页选 HSK3 后重新分析。报告底部的未分级词清单包括【工作人员】等词,也可能混有分词产生的片段;先回到原文检查,再决定是否补充自定义词典。
04
用在教学材料审阅中
把同一批材料分别运行,先比较所选词表下的整体等级与覆盖率,再查看高频未分级词和超纲词。报告中的等级基于词表和分词结果;句子长短、篇章结构等阅读门槛,可以再用文本可读性分析核对。
小结:
在 TATOOLS 里先选语言和词表,目标等级只在需要筛超纲词时设置。
分清覆盖率的全部词次分母,以及整篇等级的已分级词次分母。
先核对未分级词,再把整体等级用于同一标准下的材料比较;句子难度可接着用文本可读性分析查看。
END