收回一批问卷开放题、商品评论或留言,研究者最先想知道的往往很朴素:大家是满意还是不满?一条条读能读出语气,几千条读下来却要好几天,读到后面标准也容易走样。TATOOLS 的 Mia 情感分析逐条判断每句话是在夸、在骂,还是说不上夸骂,再把整批汇总成比例,并把它拿不准的句子单独列出来。
01
Mia 是什么模型
Mia 是 TATOOLS 训练并开源的中文情感模型。三个版本的模型文件(也叫权重,是模型训练后学到的全部参数)用 Apache-2.0 协议发布在 GitHub、Hugging Face 和 ModelScope 上,个人和机构都可以免费使用,包括商用。全部测试数据和训练脚本,连同 12 次训练与 4 个对照模型的逐次报告,也都在 GitHub 仓库里,每个成绩都能照着重算。
衡量准不准,用的是两套公开的测试材料,训练时都没见过。
| 测试材料 | 条数 | 默认版本判对 |
|---|---|---|
| 真实中文短文本,与训练数据来自不同来源 | 5,372 | 88.1% |
| 中文测试表格,覆盖 30 个行业和 5 种文体 | 900 | 94.0% |
TATOOLS 还把 7 个常用的开源中文情感模型放到同一套测试、同一张显卡上重测。在 5,372 条真实短文本上,它们当中成绩最好的判对 69.3%。这 7 个模型里有 4 个只能在夸和骂之间二选一,没有说不上夸骂这一档。只看本来就有明确褒贬的句子、只问夸还是骂时,Mia 默认版本判对 97.8%,7 个模型里最好的是 92.1%。
02
三种判断各指什么
报告里用【正面】【负面】【中性】三个词记录判断,对应的意思如下。
| 报告里的词 | 意思 |
|---|---|
| 正面 | 在夸:满意、赞赏、喜爱、感谢或推荐 |
| 负面 | 在骂:不满、失望、批评、愤怒或担忧,反讽按作者真正的态度算 |
| 中性 | 说不上夸骂:只陈述事实、说明情况、提问或叙述 |
同一句里又夸又骂、分不出偏向哪边的,默认版本和第二个版本也算作中性;第三个版本没有专门学过这类句子,归到哪一类不固定。
Mia 仓库给了两个例句。【这家店的服务真的没话说】判为正面,把握 0.9943;【本次记录涉及这家快递网点,相关信息来自页面与服务记录】判为中性,把握 0.9998。
03
每条会拿到三个数
Mia 给每一条算出三个数:负面、中性、正面各占几成,三个数加起来是 1。最大的那一类就是判断结果,这个最大的数叫【把握】。例如三个数依次是 0.10、0.75、0.15,结果是中性,把握 0.75。
把握经过校准。默认版本在公开测试集上,把握和实际判对的比例平均只差约 1 个百分点:它说有九成把握的判断,大约九成是对的。TATOOLS 的报告因此把把握低的句子单独列出,留给研究者回到原文再读。
04
整批的比例怎么算
报告把参与判断的句子数记为【判断条数】。某一类的占比等于这一类的条数除以判断条数。例如 20 条里负面 5 条、中性 12 条、正面 3 条,三类依次占 25%、60%、15%。去掉网页标签、链接和表情之后没有文字的条目不参与判断;超过 512 字的只看前 512 字。
【只分正负时】换一个问法:不管中性,每条只比较夸和骂哪边的数大。原先判为中性的句子也会被分到一边,所以这里的偏正面占比常常比三类里的正面占比高。这一栏适合对接只分正负两类的研究设计。
05
在任务页提交
打开 TATOOLS 的 Mia 情感分析,在【上传文本】区域上传文档。【模型版本】有三个选项:想把差评和抱怨尽量一条不漏地找出来,选第一个,也就是默认版本;只想快点看出整体是夸得多还是骂得多,选第二个;数据特别多、只想先快速粗扫一遍,选第三个。选项下方的卡片列出开源地址和三个版本的成绩。设置好之后向下滚动,点【提交任务】,完成后打开报告。
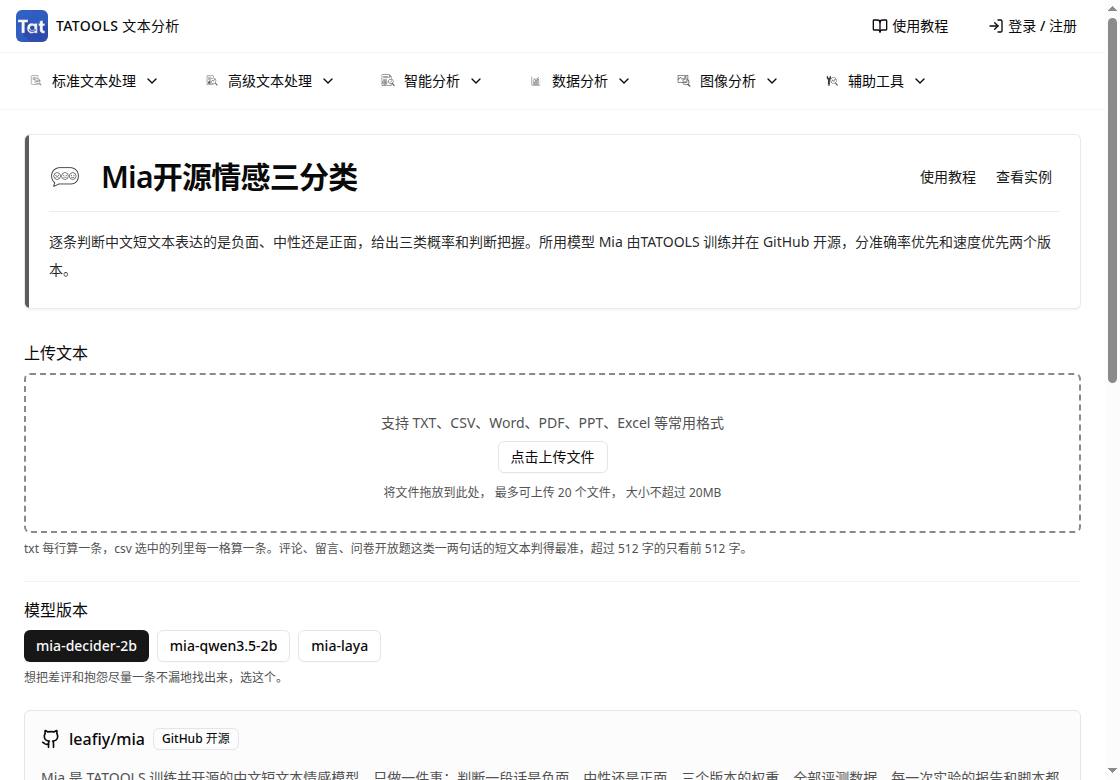
Mia 情感分析任务页的上传区域与三个模型版本
06
用公开实例读报告
点工具页右上角的【查看实例】,可以打开 TATOOLS 的公开实例。实例上传了 Mia 仓库公开的三份中文测试表格,选的是第三个版本。表格里的每一格都当作一条交给了模型,编号、行业名这类短字段也在其中,所以报告一共判断了 5400 条,中性偏多。用自己的材料时,只交装着正文的内容,比例才对应真实的态度构成。
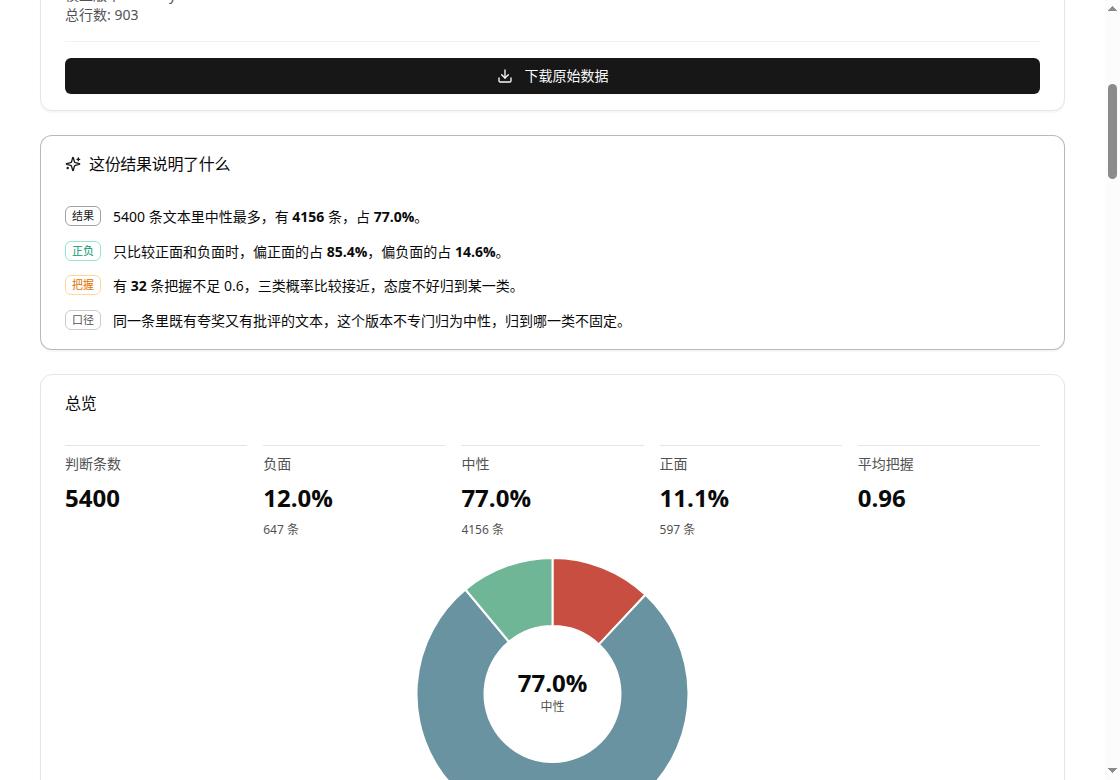
Mia 情感分析公开实例的结果说明与总览
报告顶部的【这份结果说明了什么】先用几句话交代结果。【总览】记录负面 647 条,占 12.0%;中性 4156 条,占 77.0%;正面 597 条,占 11.1%。三个占比的分母都是 5400。【只分正负时】逐条重新比较夸和骂,偏正面占 85.4%。
再往下,【把握分布】按把握高低分档,本例有 32 条把握不足 0.6,单独列在把握不足的表格里。【各文件对比】把三份材料并排,【每类最有把握的文本】挑出每一类最典型的原话。报告上方的【下载原始数据】给每份材料一张逐条结果表,包含判断、三个数和把握。
07
小结
Mia 是 TATOOLS 训练并开源的中文情感模型,模型文件、测试数据和实验报告都能公开查到。
每条句子得到三个数,最大的那一类是判断结果,最大的那个数是把握。
各类占比的分母是判断条数;【只分正负时】对同一批句子只比较夸和骂。
把握低的句子单独列出,方便回到原文核对。
想同时看情绪的强弱和唤起程度,可以接着读 TATOOLS 的【VAD 三维情感分析】教程。
08
资料来源
END