关键词抽取做的事情是:从文本中自动找出最重要的词或短语,按权重排序。
系统同时跑两种算法,各有侧重。
- TF-IDF 看的是"稀有但重要"。一个词在当前文本里出现得多,在其他文本里出现得少,它的 TF-IDF 权重就高。简单说,这个词对你这篇文档特别有代表性。
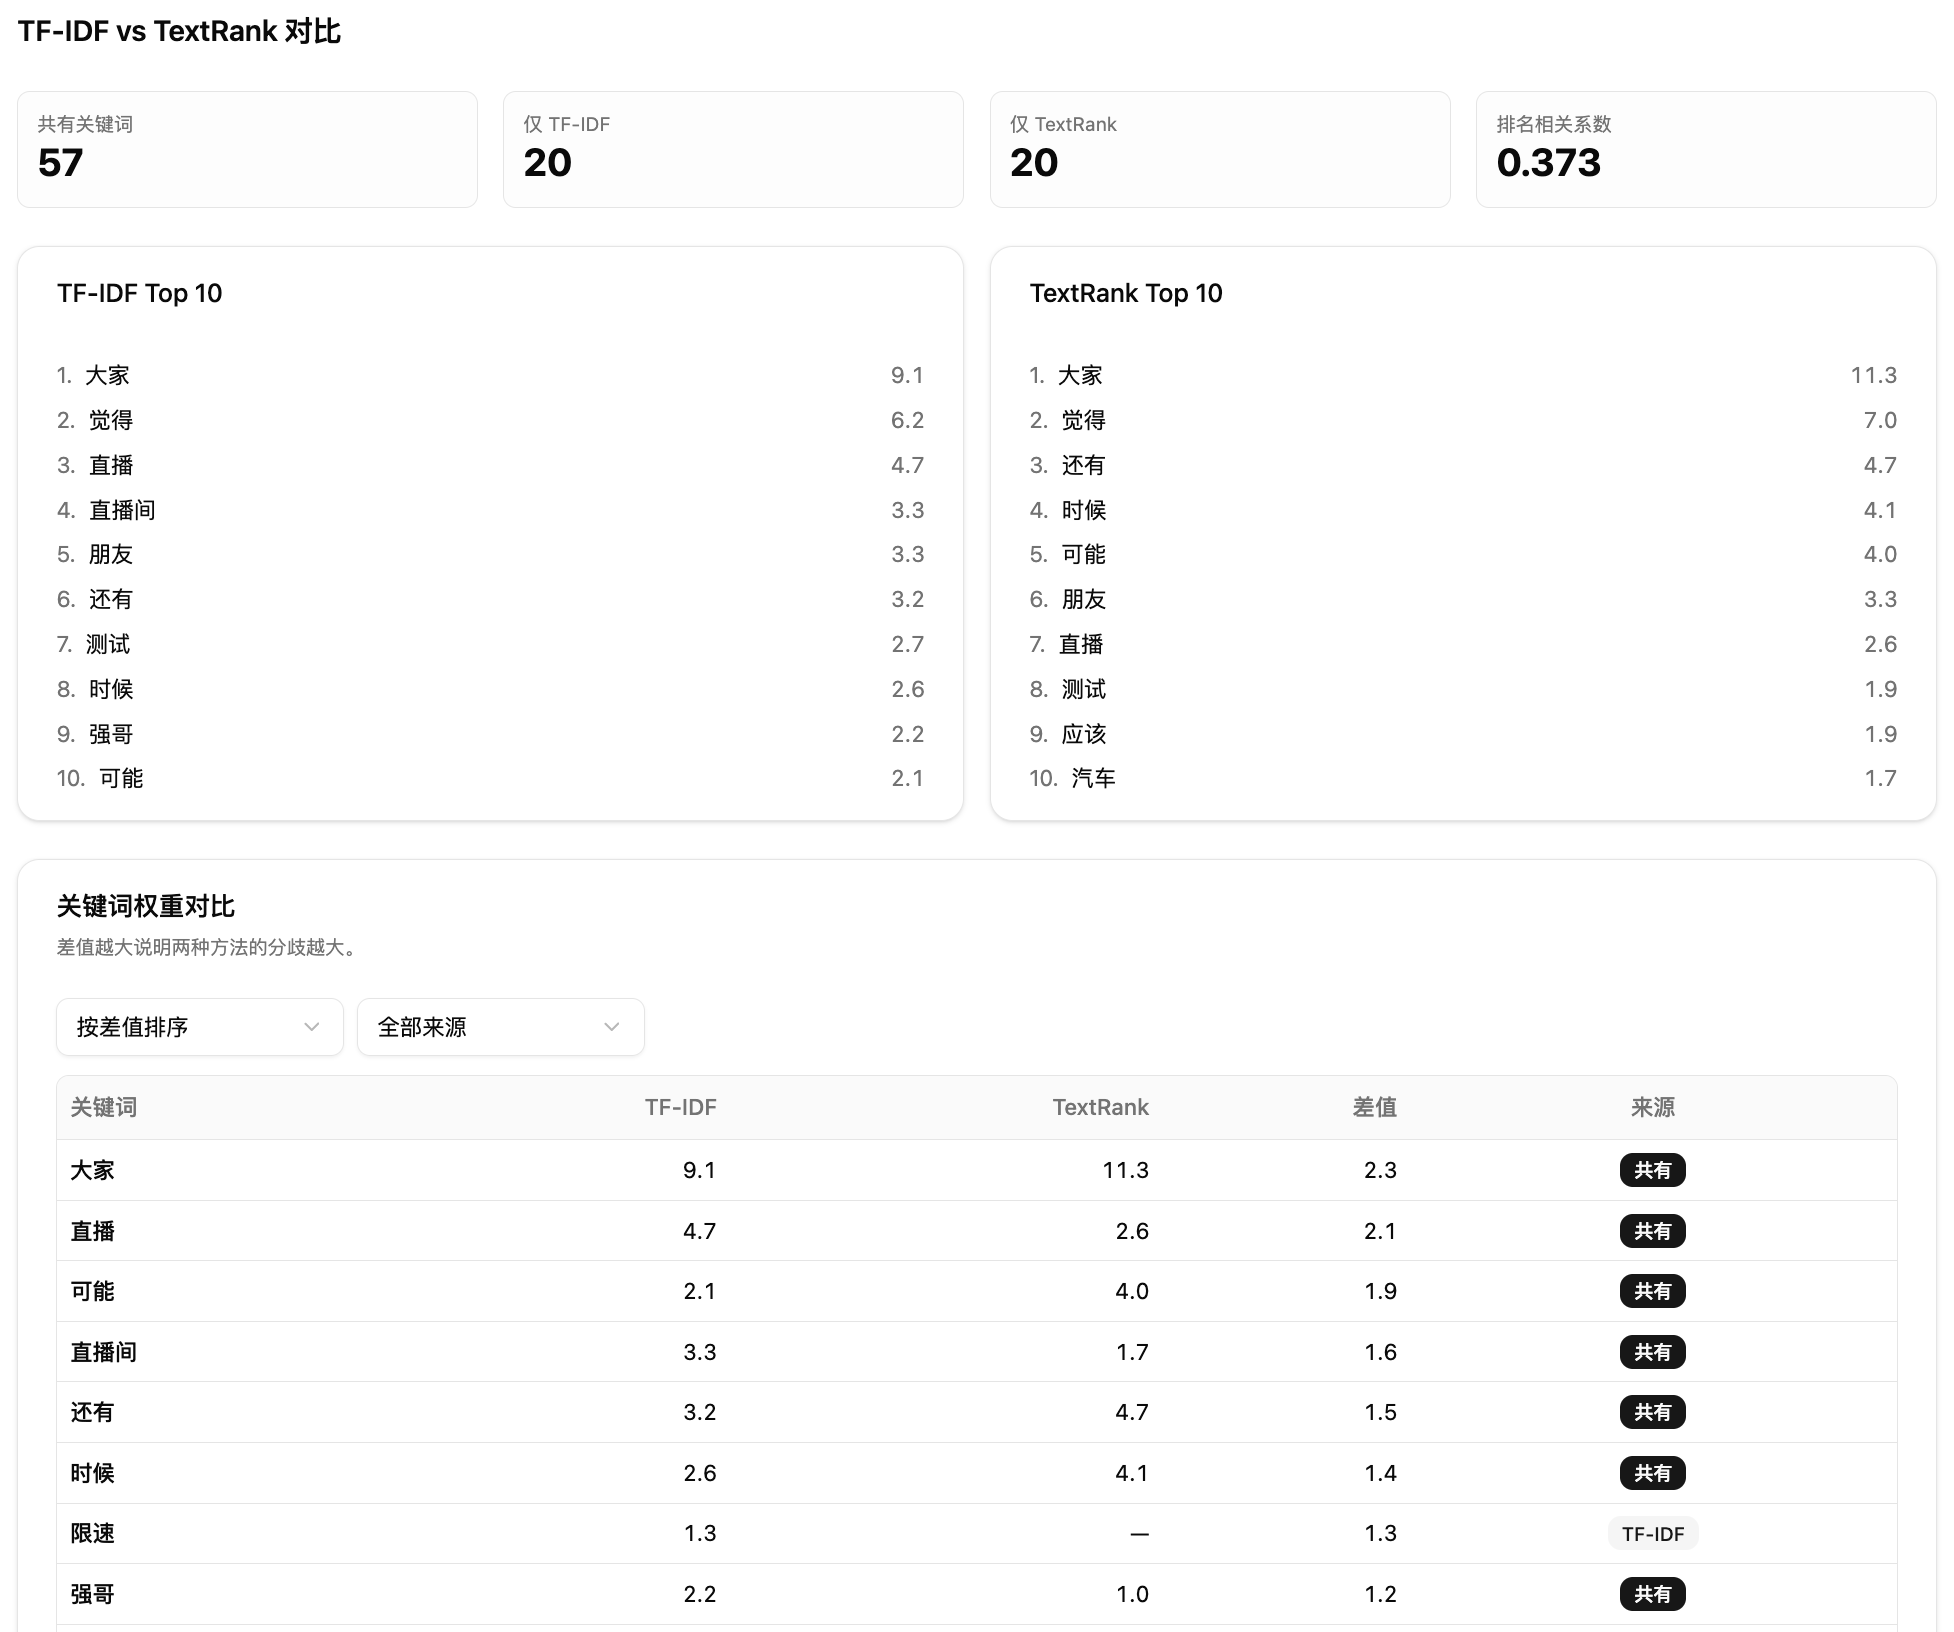
- TextRank 看的是"上下文互相支撑"。它把文本里的词当作图里的节点,两个词经常一起出现就连一条边,最终通过图排序算出哪些词和更多词产生共现关系。和更多词关联紧密的词权重更高。
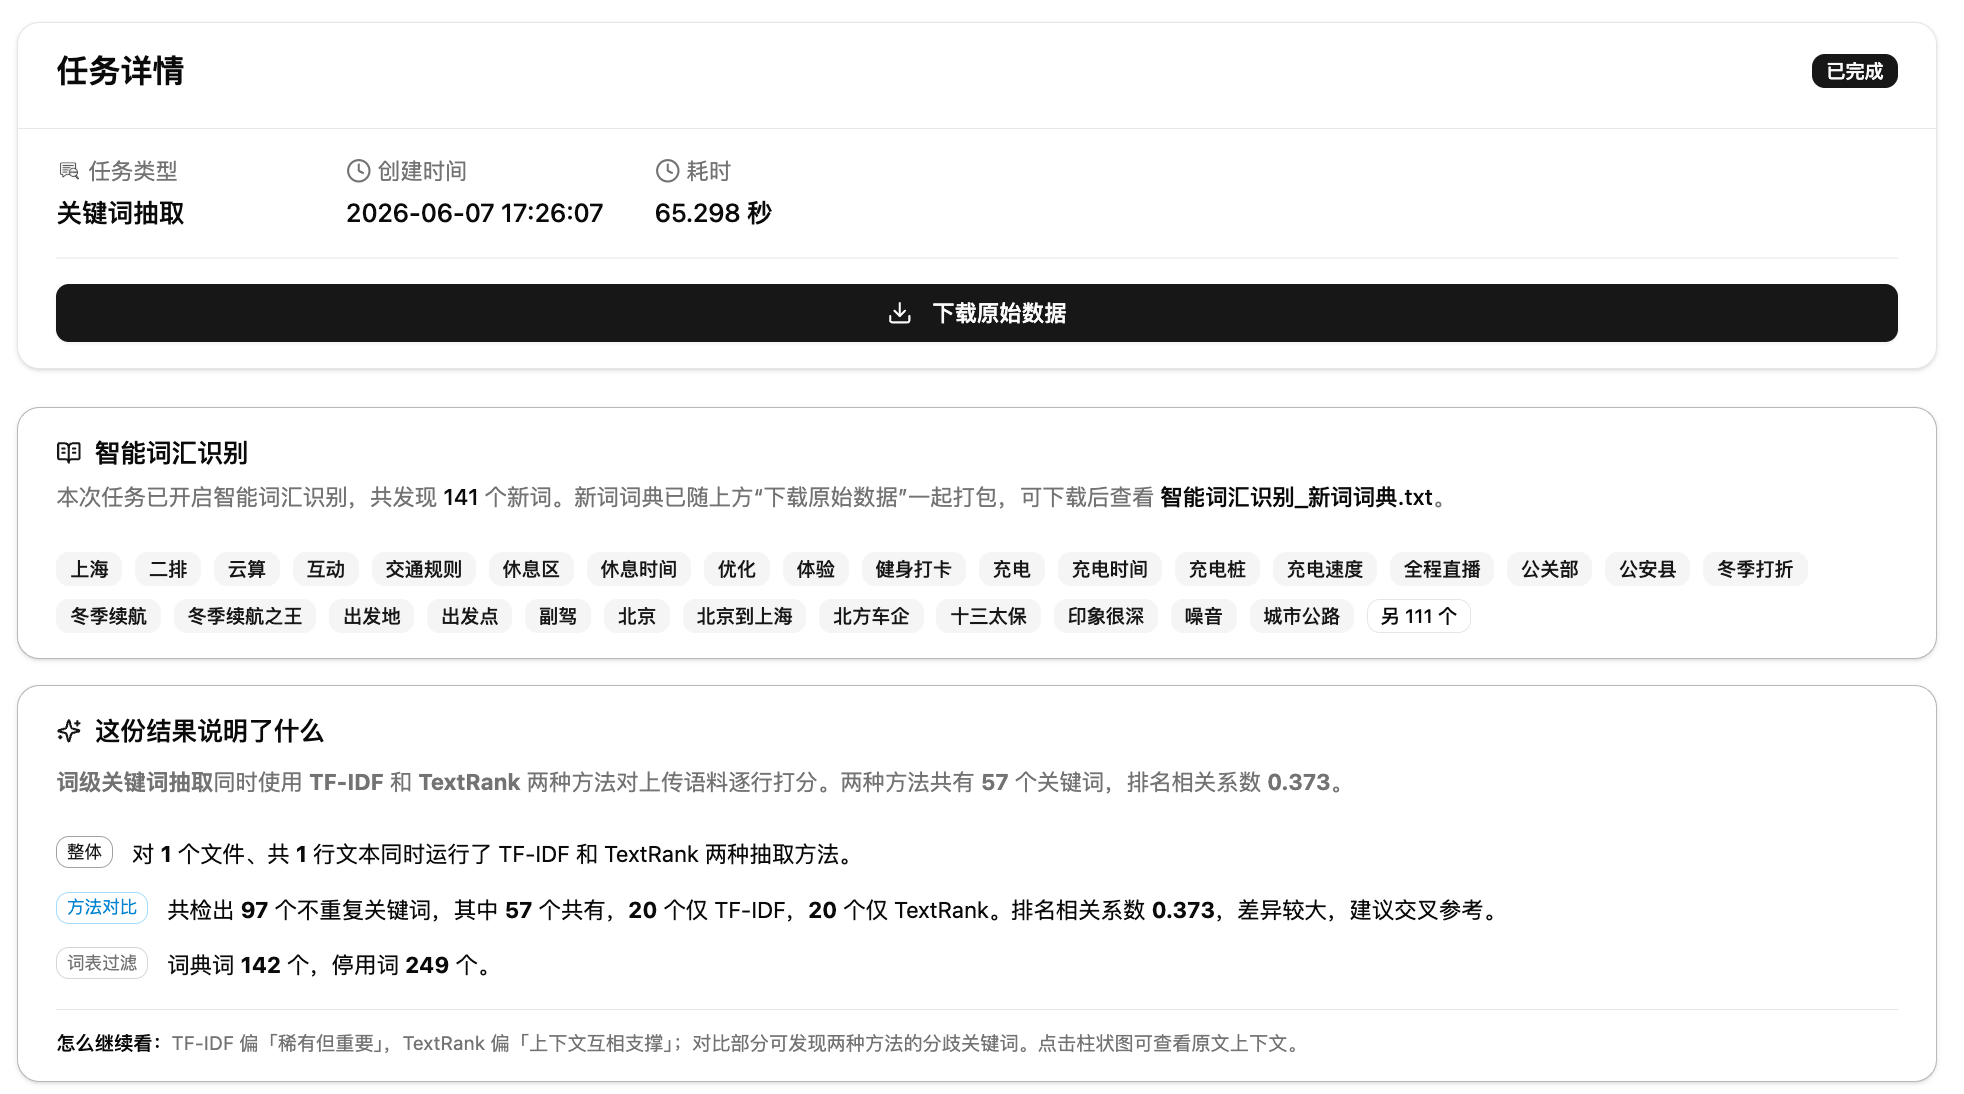
两种算法跑完后,系统自动做三件事:一是统计共有关键词和各自独有词,二是计算 Spearman 排名相关系数衡量两种方法的一致性,三是把差值最大的词标出来。相关系数高说明两种方法认同度高,结果可信;差值大的词值得重点关注,可能是某种算法捕捉到的独特信号。
报告页还包含词云、权重柱状图、跨文件对比表、噪声词过滤面板、密度诊断和主题聚类等多个分析模块,帮你从不同角度看关键词。
适用文档
目前支持两种输入格式。
- TXT 文件。按全文处理,一个文件算一个整体。编码建议用 UTF-8,其他编码出现乱码可以先转一下。
- CSV 文件。按行处理,每一行独立提取关键词。自动识别文本列,非文本列原样保留。需要带表头。
中文和英文都支持,系统会自动识别语言。中英混排也可以处理,中文部分和英文部分分别用对应的分词策略。
适用情景
- 竞品内容分析。把竞品文章批量上传,提取关键词后对比共享词和独有词,找到差异化关键词做内容策略。
- 学术文献综述。从论文摘要或全文中提取学科术语,用跨文件对比功能识别高频共现术语和各篇独有术语。
- 用户评论挖掘。从电商评论、问卷开放题中提取功能点和痛点关键词,密度诊断帮你判断哪些词被反复提及。
- 政策文本分析。从政策文件中提炼核心概念和关键表述,主题聚类会把语义相近的关键词自动分组。
- SEO 内容优化。提取目标页面的关键词权重分布,检查关键词密度是否在合理范围,避免堆砌或不足。
使用步骤
第一步:上传文件。你可以上传一个或多个 TXT 或 CSV 文件,系统逐个处理。
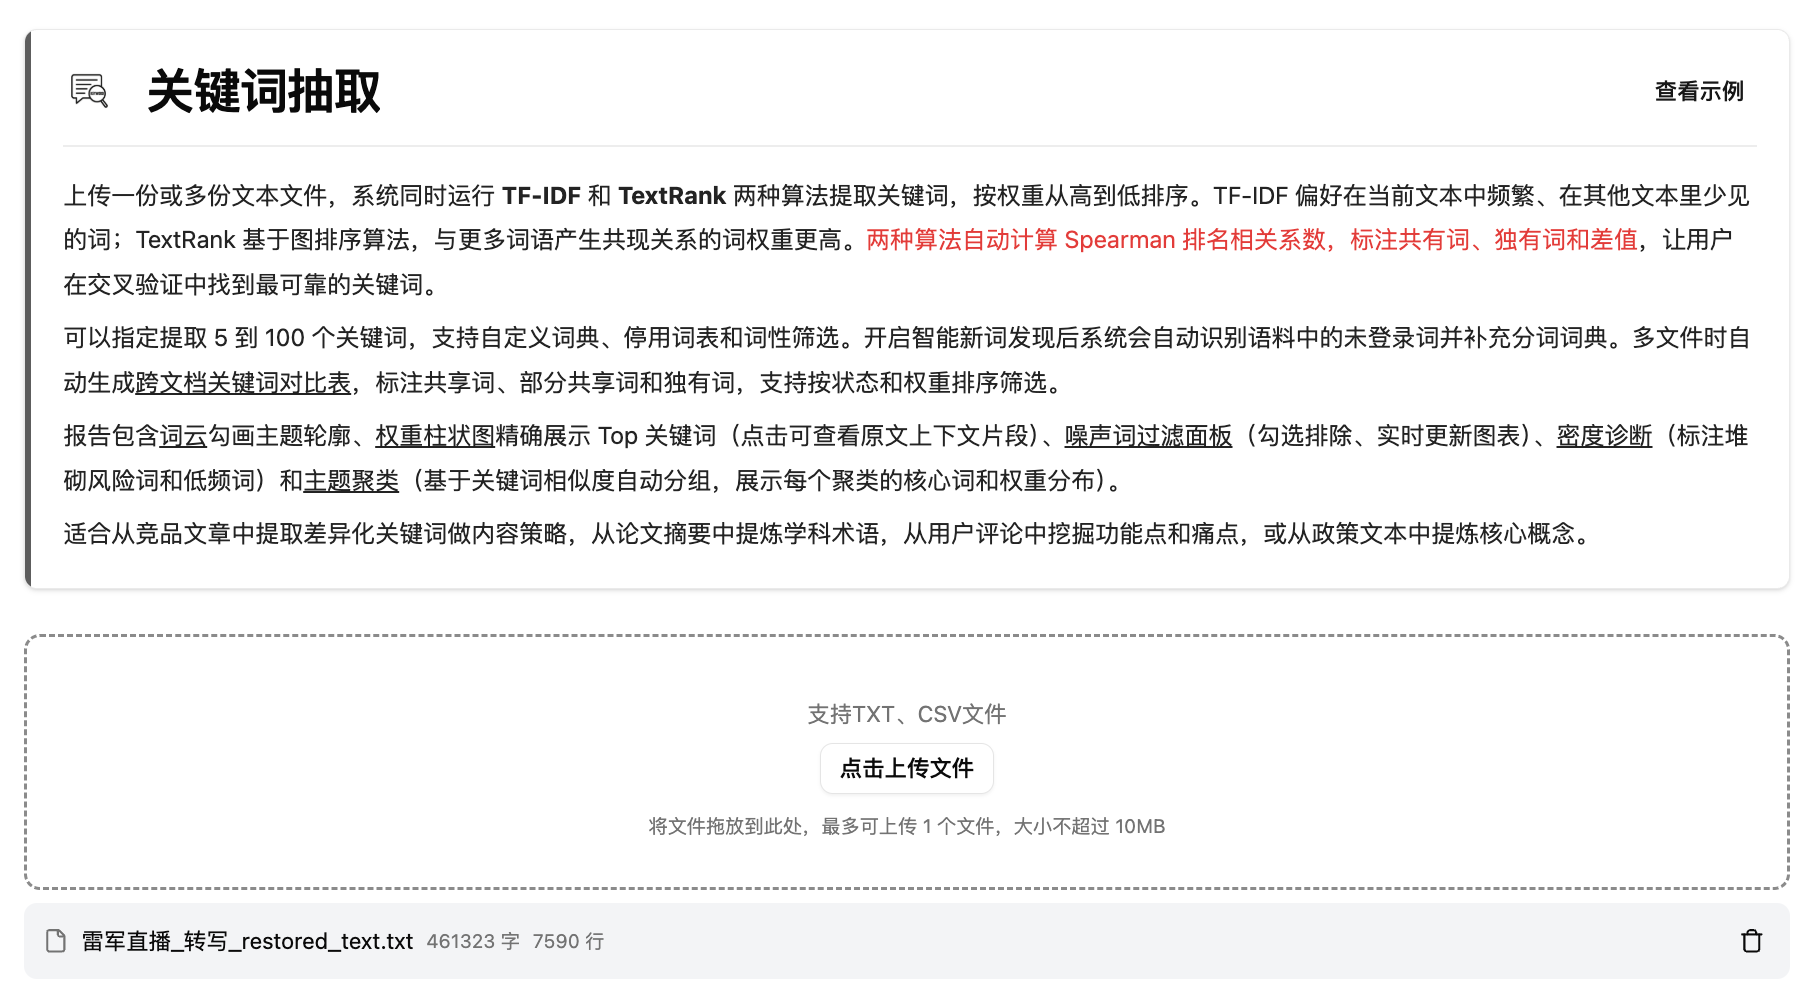
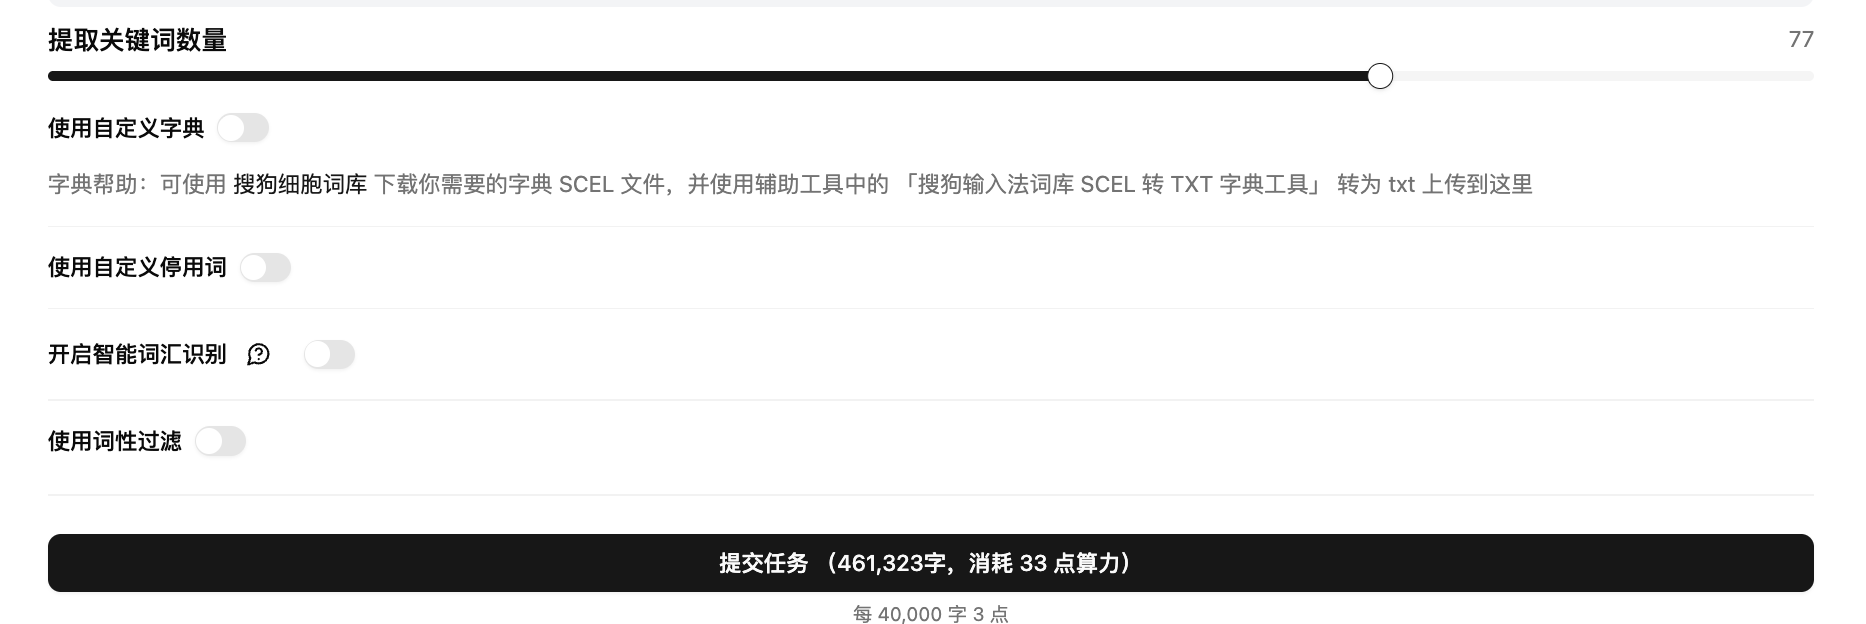
第二步:配置参数。上传后页面显示参数配置区域,默认提取 20 个关键词。你可以调整提取数量、上传自定义词典和停用词表、开启词性筛选等,具体含义在下一节展开。
第三步:查看报告。提交后系统自动处理,完成后跳转到报告页。报告从上到下依次是:数据解读卡片、TF-IDF 结果区、TextRank 结果区、两种方法的对比区。
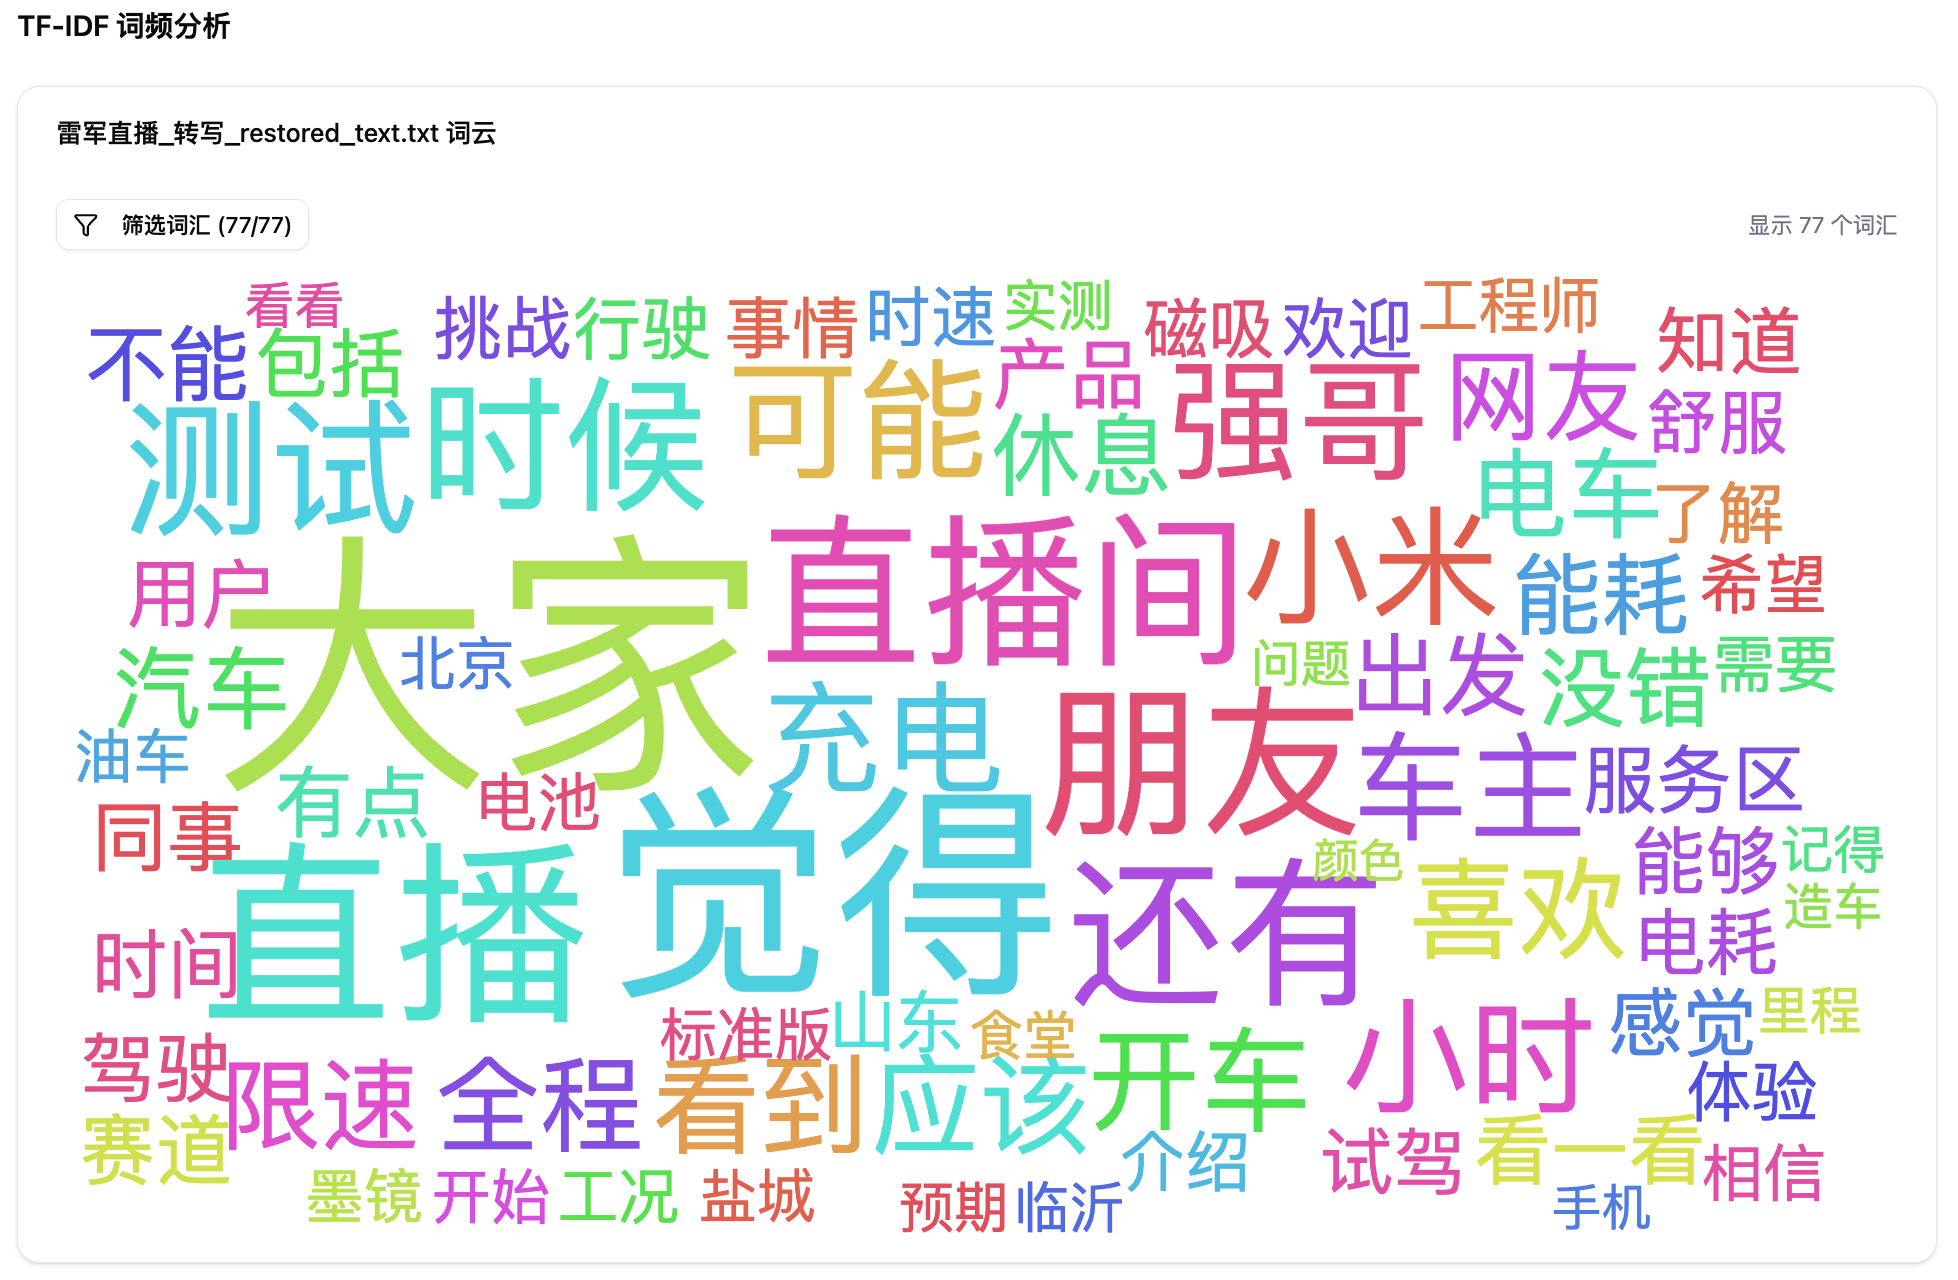
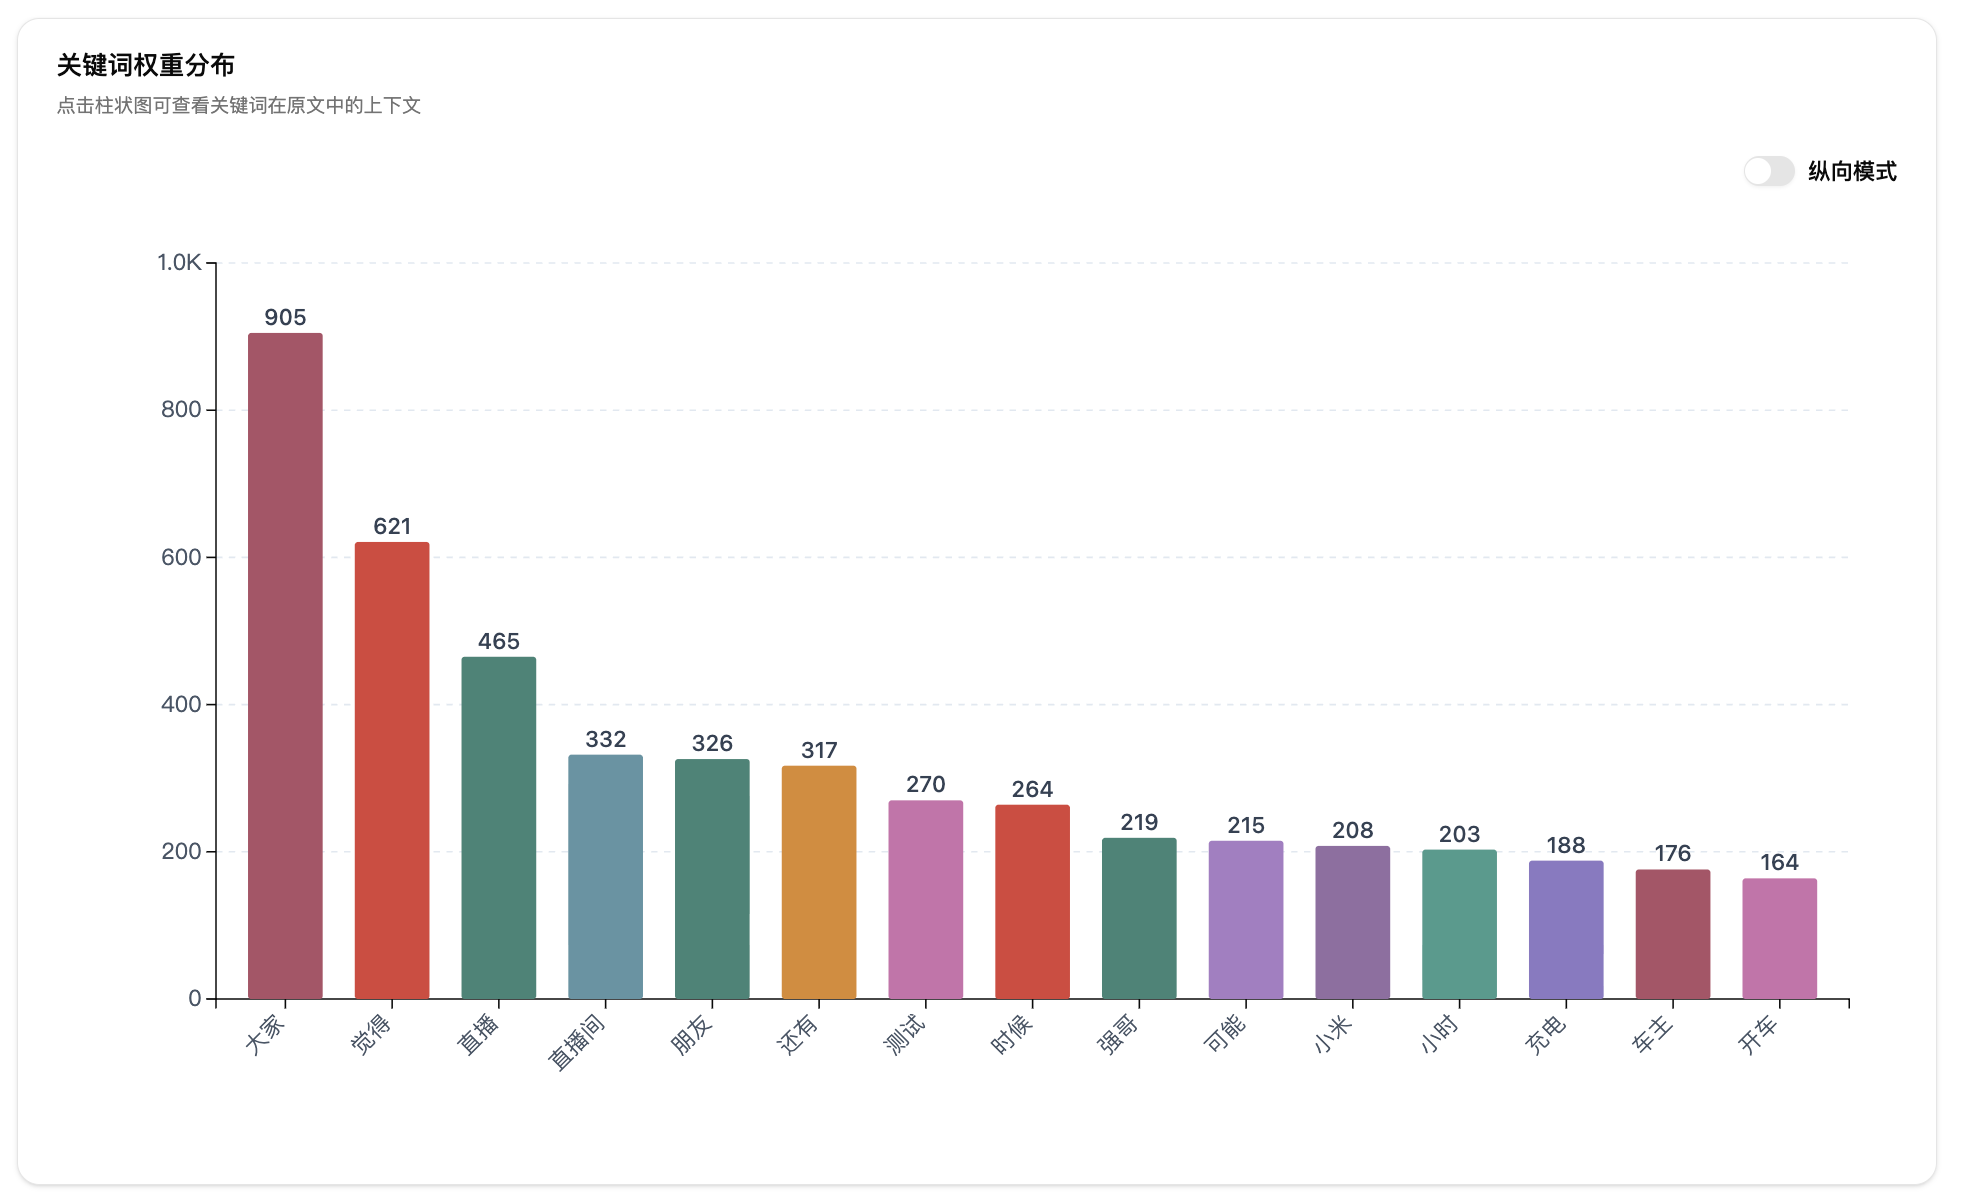
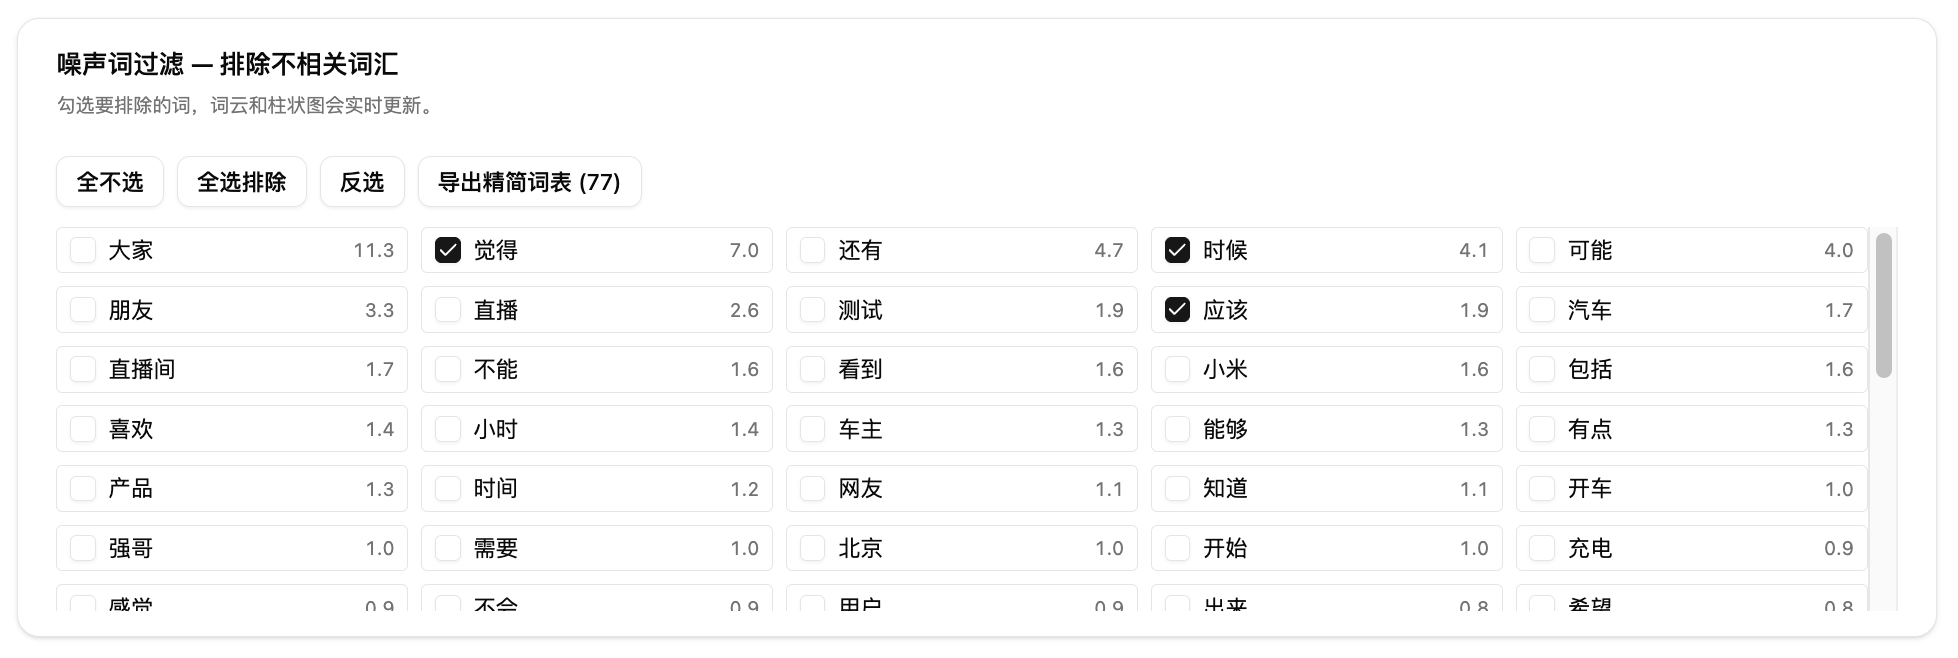
第四步:筛选与导出。在噪声词过滤面板勾选要排除的词,词云和柱状图会实时更新。点击柱状图可以查看关键词在原文中的上下文片段。筛选完成后可以导出精简词表。
第五步:下载结果。点击下载拿到每种方法的 CSV 结果文件,包含关键词、权重和总分。
参数解析与对比示例
可配置参数如下。
| 参数 | 说明 | 默认值 |
|---|---|---|
| 提取数量 | 每种方法提取的关键词数量,范围 5-100 | 20 |
| 自定义词典 | 上传词典文件,每行一个词,帮助分词工具识别专有名词和领域术语 | 未上传 |
| 自定义停用词表 | 上传停用词文件,每行一个词,提取前自动过滤这些词 | 未上传 |
| 词性筛选 | 开启后排除指定词性类别,默认保留名词、动词、形容词等实义词 | 关闭 |
| 排除词性 | 勾选要排除的词性类别(需先开启词性筛选) | 无 |
| 语言 | 文本主要语言,影响分词策略 | 中文 |
| 智能新词发现 | 自动发现语料中的新词,补充分词词典 | 关闭 |
三组典型配置供参考。
- 快速提取。保持默认配置,提取数量 20,其他参数不动。适合初次使用,快速看结果。处理速度快。
- 术语强化提取。上传自定义词典,包含领域专业术语。适合医学、法律、IT 等专业文档,能减少术语被错误切分的情况。提取数量建议设为 30-50。
- 精细筛选提取。开启词性筛选,排除介词、连词、助词等功能词,同时上传自定义停用词表。适合需要纯净实义关键词的场景。结果更聚焦,但可能漏掉一些有分析价值的虚词搭配。
提取数量设得越多,覆盖越全但噪声也越多。一般来说 20-30 适合快速浏览,50 以上适合深度分析。
案例分析
案例一:竞品文章关键词对比。
背景:某内容团队收集了 5 篇竞品公众号文章,想找出差异化关键词做选题参考。
配置:提取数量 30,其他参数默认。
结果:5 篇文件共检出 87 个不重复关键词。TF-IDF 和 TextRank 共有关键词 23 个,排名相关系数处于中等一致性水平。跨文件对比表显示共享词 12 个(如"用户""内容""平台"),各篇独有词 5-8 个不等。团队重点关注 TextRank 独有的关键词,发现"留存""转化""裂变"这类运营词在 TextRank 中权重更高,说明它们在原文中和其他词的共现关系更紧密。
结论:两种方法的分歧关键词往往是价值所在。TF-IDF 捕捉稀有但有代表性的词,TextRank 捕捉上下文关联紧密的词,交叉参考后选题方向更全面。
案例二:用户评论痛点挖掘。
背景:某产品团队收集了 200 条用户评论(CSV 格式,每行一条评论),想了解用户最关心的功能点和痛点。
配置:提取数量 50,开启智能新词发现,自定义停用词表包含"一个""这个""那个"等口语化填充词。
结果:每行评论独立提取关键词后汇总。密度诊断显示"卡顿""闪退""加载"三个词的密度超过 5%,属于高频堆砌词,反映了用户最集中的痛点。主题聚类把关键词分成 5 组:性能相关(卡顿、加载、闪退)、功能相关(搜索、筛选、收藏)、界面相关(布局、字体、颜色)、价格相关(优惠、折扣、会员)、服务相关(客服、退款、投诉)。
结论:密度诊断帮你快速定位高频问题词,主题聚类帮你把散乱的关键词归类成可操作的问题域。
类似功能对比
关键词抽取和高频词提取、词性标注都跟"词"有关,但做的事情不一样。
| 对比维度 | 关键词抽取 | 高频词提取 | 词性标注 |
|---|---|---|---|
| 做什么 | 用算法提取最重要的词 | 按出现次数统计最常见的词 | 给每个词标语法类别 |
| 关注点 | 词的重要程度和代表性 | 词的出现频率 | 语法结构和词性分布 |
| 考虑上下文 | 是(TextRank 基于共现关系) | 否(纯频次统计) | 否(只关注词性) |
| 输出 | 关键词列表 + 权重排序 | 词频表 + 频次排序 | 词性分布 + 转移矩阵 |
| 典型场景 | 主题分析、标签生成、SEO | 词频统计、语料概览 | 语法研究、风格分析 |
高频词提取只看出现次数,"的""了""是"这类虚词如果没过滤掉会排在最前面。关键词抽取通过 TF-IDF 和 TextRank 算法过滤掉了这类常见词,结果更接近文本的核心主题。词性标注可以和关键词抽取组合使用:先标注词性,再按名词、动词等类别筛选后做关键词抽取,结果更聚焦。
01
在任务页面完成关键词抽取
打开关键词抽取页面。已有的关键词抽取实例将【提取关键词数量】设为 40,可用于对照参数与报告。
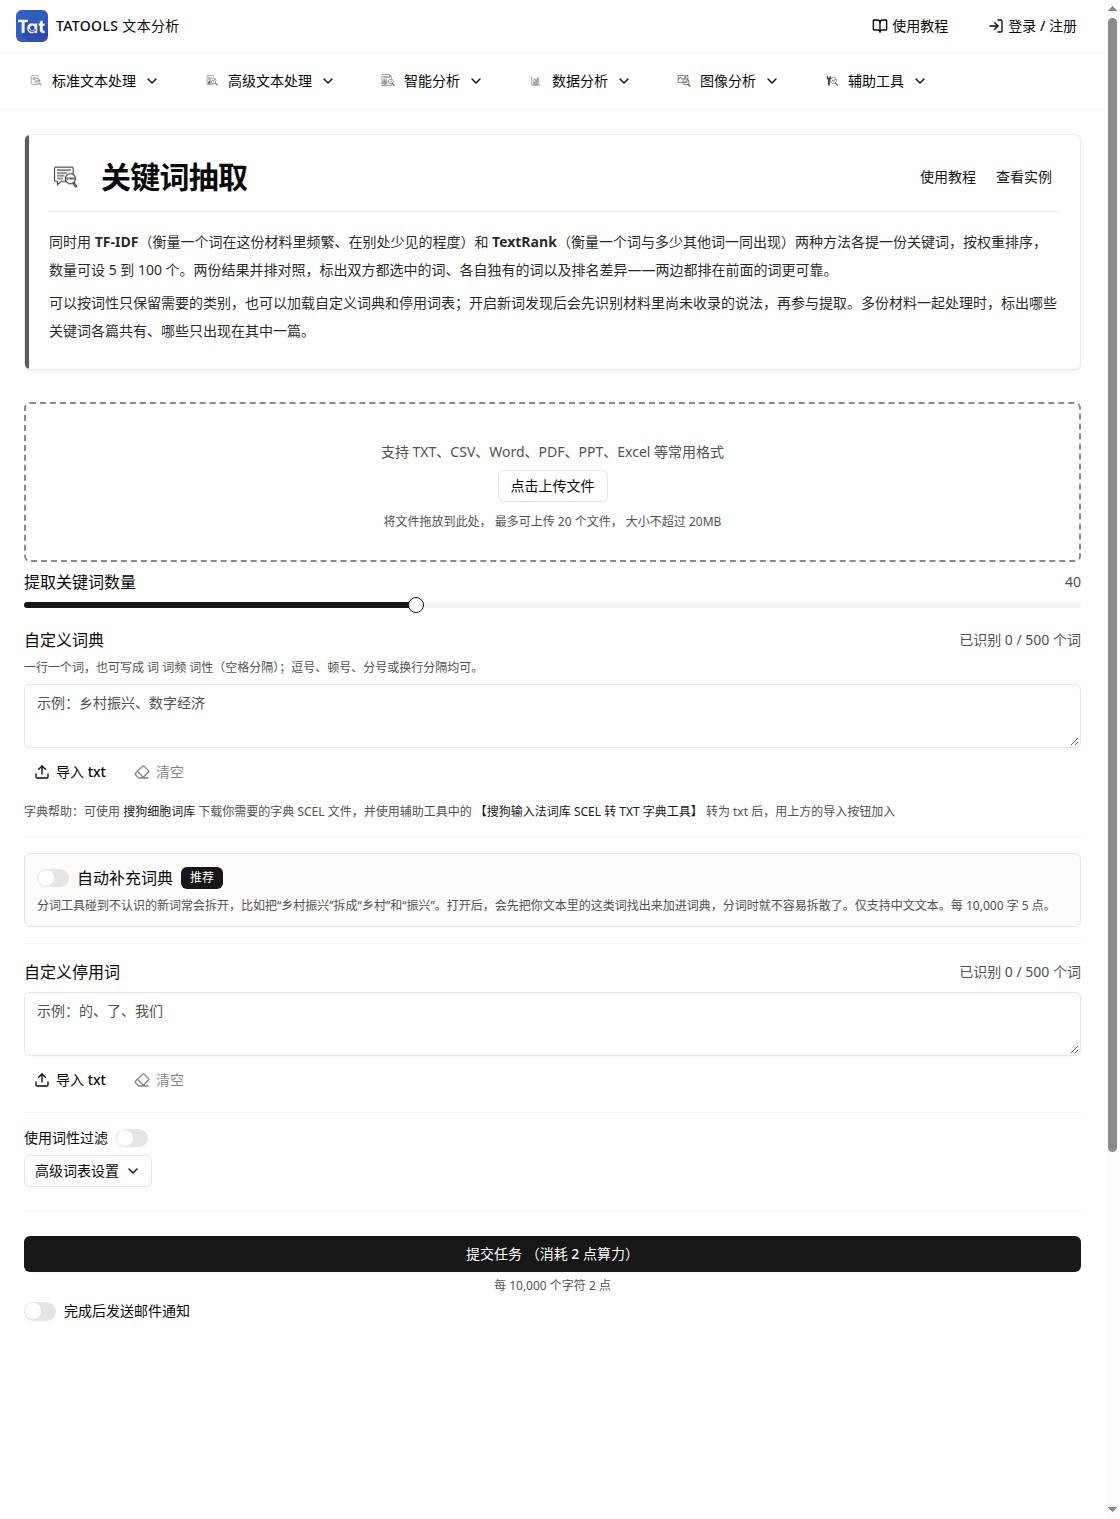
关键词抽取任务页面:设置提取数量、词典、停用词与词性过滤,词形合并位于高级词表设置中
上传文档。 需要逐篇比较关键词时,将材料分别作为文件上传。
设置提取数量。 调整【提取关键词数量】。这个设置控制所保留关键词的上限;候选词不足或过滤后数量减少时,实际结果可能少于设定值。
补充术语与排除词。 在【自定义词典】中加入希望完整识别的术语,在【自定义停用词】中加入本次分析需要排除的词。不要因为某个词出现频繁,就直接把它当作无意义词删除。
按需要设置过滤与词形合并。 【使用词性过滤】用于排除选中的词性类型;展开【高级词表设置】后,可在【词形合并】中将同一概念的不同写法归到统一写法。原词、简称确实指向同一对象时,再加入合并规则。
提交并查看两种方法的结果。 任务完成后,分别查看 TF-IDF 与 TextRank 区块。同一份文件应在两种方法下分别核对,先看高位词,再看两种方法共有和独有的词。
导出需要保留的词表。 报告提供噪声词过滤和【导出精简词表】。筛选后核对词云、柱状图和导出数量,再保存与本次研究问题有关的关键词列表。
已有实例的提取数量为 40,没有启用新词发现或词性过滤,也没有配置自定义词典或自定义停用词。它说明的是这组设置下的结果;换用自己的材料或词表后,结果需要重新核对。
02
报告中的词云、权重与方法对比
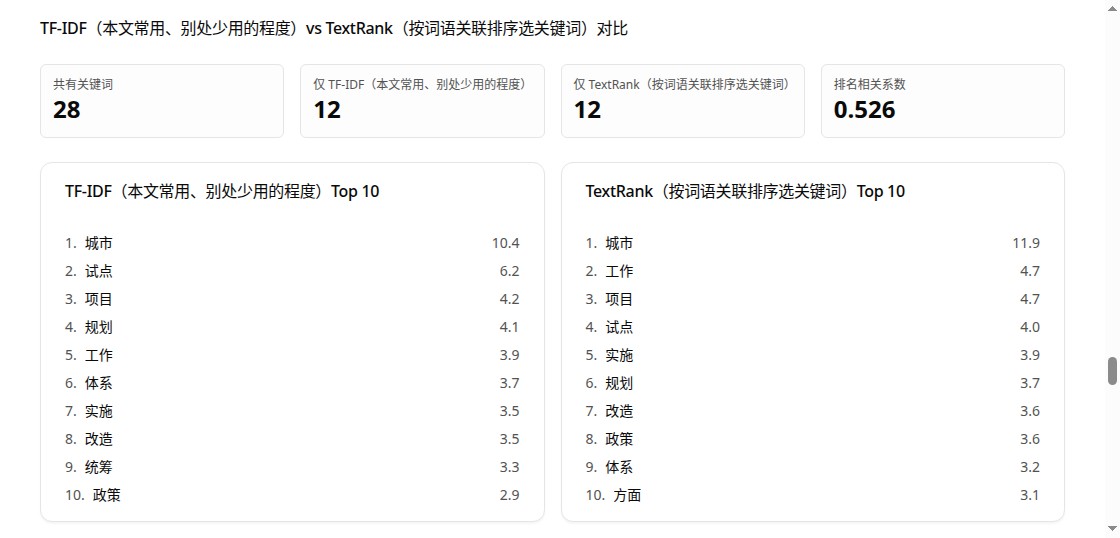
关键词抽取实例的方法对比:两种方法共有 28 个关键词,各自独有 12 个,下方并排展示前 10 个词
这个实例中,两种方法各保留 40 个关键词,其中 28 个相同、各自独有 12 个,合并去重后共有 52 个词。【城市】在两份榜单中都排第一;【试点】在 TF-IDF 中排第二,在 TextRank 中排第四;【工作】分别排第五和第二。这样的对照能具体指出两个列表的差异,是否保留这些词还要结合原文语境。
先确认算法和文件。 报告分别展示 TF-IDF 和 TextRank。多文件任务可在各自区块切换文件,不要把一个算法下的文件 A 与另一个算法下的文件 B 当作同一材料比较。
词云和柱状图展示的是关键词权重。 词语更醒目或条形更长,表示它在当前方法与当前结果中的权重更高。权重不是出现次数,也不是该词占全文字数的比例;两种方法的数值不能直接相减来判断哪个算法更准确。
【跨文件关键词对比】比较进入结果词表的词。 多文件结果具备该区块时,可以按状态或权重排序,查看共享词、部分共享词和独有词。一个词没有进入某份文件的关键词列表,并不等于它在该文件原文里从未出现;提取数量与过滤设置都可能影响入选结果。
方法对比区列出共有词与各自独有词。 两种方法都选中的词可以优先回到原文核对;只被其中一种方法选中的词也可能与研究问题有关。应结合词语所在句段判断其作用,不能把交集当作已经验证正确的答案。
噪声词过滤用于整理当前结果。 页面中的筛选会更新词云和柱状图,并提供精简词表导出。若需要让某些词从抽取阶段就被排除,应将它们加入任务页的停用词后重新提交;报告中的即时筛选与重新计算属于不同操作。
END