读完一部长篇小说,常常说得出它先苦后甜还是一路悲凉,却很难指出情绪在第几章跌到谷底,又在哪里开始回升。回忆录、口述史和长篇报道也一样,情绪的起落藏在几十万字里,要画出来得靠逐段细读和大量笔记。
计算文学研究给这件事找到了办法。把一部作品从头到尾切成许多连续的小片段,逐段判断情绪,再按位置连成一条曲线,作品的情绪走势就能画出来。Reagan 等人 2016 年用这种方法分析了上千部英文小说,发现它们的情绪曲线大多可以归入六种基本形状,印证了作家冯内古特关于故事形状的说法。
在 TATOOLS 的【全文情感曲线】里【上传文档】,TATOOLS 把每份文本切成一百多到三百多个连续片段,逐段判断效价、唤醒度和主导情绪,并摘一句原文作证据;再把逐段分值按位置压成 100 个点并平滑,标出高点、低谷与转折,和六种经典情绪弧比对,给出开局到结局的三段对比和九类情绪的构成,最后附一段整体解读。
这篇教程先讲情绪用哪几个维度刻画,再讲片段怎样切、怎样打分,然后用小例子讲清曲线平滑、转折点检测和情绪弧匹配,最后讲报告的读法和论文里的写法。
01
情绪的几个维度
心理学刻画情绪有两种传统。一种是维度,Russell 1980 年提出情绪的环形模型,用两根轴描述几乎所有情绪状态,效价表示愉快还是不愉快,唤醒度表示平静还是激动。Bradley 和 Lang 1994 年的自我评定量表在这两轴之外,又加了一根支配度,表示是主动掌控还是被动无力。另一种是类别,Plutchik 提出八种基本情绪,喜悦、信任、恐惧、惊讶、悲伤、期待、愤怒和厌恶。
| 维度 | 取值范围 | 两端 |
|---|---|---|
| 效价 | −1 到 1 | 极度负面到极度正面,0 是中性 |
| 唤醒度 | 0 到 1 | 平静舒缓到紧张激烈 |
| 支配度 | 0 到 1 | 被动无力到主动掌控 |
TATOOLS 两种传统都用。每个片段给出效价、唤醒度和支配度三个分值,再从 Plutchik 的八种情绪加上平静这九类里选一个主导情绪,并标出强度是轻微、中等还是强烈。情绪曲线画的是效价,张力曲线画的是唤醒度。
判断看的是叙述、对话和描写综合起来传达给读者的基调,人物嘴上说的心情只是其中一部分。
02
先切成连续片段
曲线的精细程度取决于切出多少个片段。TATOOLS 先按行首的章节标题切章,第一章和 Chapter 1 这类标题都能识别,楔子和尾声也认得出;再按换行切出自然段;然后把相邻的自然段合并成打分片段,片段不跨章。
片段目标长度 = 全文字数 ÷ 目标片段数
夹在 300 字到 2000 字之间
| 片段粒度 | 目标片段数 | 适合 |
|---|---|---|
| 精细 | 约 320 个 | 要细看起落的位置 |
| 标准 | 约 200 个 | 大多数长篇作品 |
| 粗略 | 约 120 个 | 只看大走势 |
手算两个例子。
20 万字的小说,标准粒度
200000 ÷ 200 = 1000 字一个片段,约 200 个片段
3 万字的中篇,标准粒度
30000 ÷ 200 = 150 字,低于 300,按 300 字切
约 100 个片段
合并时优先在场景切换处下刀。TATOOLS 给每个自然段算一个语义向量,相邻两段的相似度骤降,往往是场景或话题的切换,这个思路来自 Hearst 1997 年的 TextTiling 分段方法。片段攒到目标长度的六成以后,遇到这样的断裂就切开,所以片段尽量对应一段完整的情节。
文本太短、切不出足够的片段时,这份文件画不出曲线,报告里会写明原因。
03
逐段打分,起落处再细看
TATOOLS 把连续的四个片段打包,连同前一个片段作为上下文,一起交给大语言模型判断。每个片段返回三个维度的分值、主导情绪及其强度,以及从片段原文里一字不改摘出的一句证据,不超过 40 字。证据要在原文里逐字找得到,找不到就丢弃,报告里出现的证据句都能在原文里定位。某个片段漏判时,TATOOLS 单独再请求一次。
粗扫之后,情绪变化最剧烈的地方还要细看。TATOOLS 计算相邻片段之间的分差。
分差 = |效价之差| + 0.5 × |唤醒度之差|
前一段 效价 0.3,唤醒度 0.4
后一段 效价 −0.5,唤醒度 0.8
分差 = 0.8 + 0.5 × 0.4 = 1.0
分差排在前 20% 的边界两侧的片段,以及效价绝对值不小于 0.4 的局部高点和低谷,会被拆回自然段重新判断一次。细化过的片段,曲线用它的子片段;报告的【曲线概况】写明有多少个片段做了细化。
04
压成 100 个点再平滑
片段数因作品而异,TATOOLS 把逐段分值按位置落到 100 个等宽的格子里。每个片段取它中点所在的位置,同一格里的片段按字数加权平均,空格子用前后插值补齐。这样长篇和短篇都变成 100 个点,可以叠在一起比较。
逐段分值上下跳动很大,直接连线看不出走势。Jockers 2015 年在 Syuzhet 情节弧研究里用低通滤波平滑曲线,后来改用离散余弦变换,TATOOLS 沿用这个做法。离散余弦变换把 100 个点分解成 100 条频率由低到高的余弦波之和,只保留频率最低的前几条,再合成回去,快速的抖动就被滤掉了。
第 k 条余弦波在全文里起伏 k ÷ 2 个来回
保留前 K 条,最快的一条起伏 (K − 1) ÷ 2 个来回
| 曲线平滑 | 保留余弦波 | 最多起伏 |
|---|---|---|
| 轻度 | 16 条 | 七个多来回,保留局部起伏 |
| 中等 | 8 条 | 三个多来回,看主要起落 |
| 强 | 4 条 | 一个半来回,只剩大波段 |
【曲线平滑】默认中等。多部作品叠加比较时选强,对照具体章节细看时选轻度。
05
高点、低谷与转折点
平滑后的效价曲线上,明显高出或低于两侧的点记为高点或低谷。曲线是平滑过的,TATOOLS 再回到原片段,在附近找分值最极端的那一段,把它的证据句列在报告里。
转折点回答另一个问题,情绪的平均水平在哪里发生了跳变。TATOOLS 对逐段效价序列做 PELT 变点检测,这是 Killick 等人 2012 年提出的算法。它把序列切成若干段,每段用自己的均值代表,切得越准,各段内部的离差平方和越小;每多切一刀要付一份惩罚,只有减少的离差大于惩罚,这一刀才值得切。
手算一个八个片段的例子(示例)。
效价 0.2 0.3 0.2 0.3 −0.4 −0.5 −0.4 −0.5
不切 均值 −0.1,离差平方和 1.00
在第 5 段前切一刀
前段均值 0.25,后段均值 −0.45
离差平方和 0.01 + 0.01 = 0.02
减少 0.98
惩罚 = 3 × 方差 × ln 8 = 3 × 0.125 × 2.08 ≈ 0.78
0.98 大于 0.78,这一刀成立
这个转折点前后的效价均值从 0.25 跳到 −0.45,差 −0.70,是一次明显的下行。前后均值相差不到 0.1 的跳变不列出。
报告的【高点、低谷与转折】把三类位置按先后排成一张表,列出每一处的位置和分值,主导情绪和转折点的前后均值也在表里,点【原文】可以跳回原文定位。【张力曲线】单独画唤醒度,标出张力最高的几处。
06
六种经典情绪弧
Reagan 等人 2016 年的研究把小说的情绪曲线归为六种基本形状。
| 情绪弧 | 形状 |
|---|---|
| 一路上扬 | 由低到高,整体向好 |
| 一路下行 | 由高到低,整体转坏 |
| 先抑后扬 | 跌入低谷后再回升 |
| 先扬后抑 | 冲上高点后再跌落 |
| 扬—抑—扬 | 升起、跌落、再升起 |
| 抑—扬—抑 | 跌落、回升、再跌落 |
TATOOLS 为每种形状准备一条 100 点的模板,一路上扬是一条斜线,先抑后扬是一个完整的余弦谷,把平滑后的效价曲线和六条模板分别算相关系数,取最高的一个。
手算一个五点的简化例子(示意)。
曲线 0.6 0.1 −0.5 0.0 0.5
先抑后扬模板 1 0 −1 0 1
相关系数 ≈ 0.99
一路上扬模板 0 0.25 0.5 0.75 1
相关系数 ≈ −0.11
这条曲线先跌后升,和先抑后扬几乎完全吻合。相关系数不小于 0.8 算弧型明显,0.6 到 0.8 算大体成立,低于 0.6 说明没有明显的经典弧型,报告的【曲线概况】会写明是哪一档。
07
开局、中段与结局
TATOOLS 把全文按位置三等分,分别计算开局、中段和结局的平均分值,效价、唤醒度和支配度都按字数加权,并给出每一段字数最多的主导情绪。三段一比,先苦后甜还是由盛转衰,一目了然。
【情绪构成】统计九类主导情绪各占全文多少,按片段字数加权;还把全文按位置分成十段,画出每一段里各类情绪的占比,看得到恐惧集中在哪里,喜悦又在哪里出现。【曲线概况】另外给出整体效价、整体唤醒度,以及正面和负面片段所占的比例,效价高于 0.2 记正面,低于 −0.2 记负面。
08
关注词与整体解读
在【关注词】里填上人物名、地名或任何词语,TATOOLS 在曲线下方标出它们出现的全部位置,并统计包含这个词的片段平均效价和唤醒度。一个人物每次出场时情绪偏正还是偏负,一张表就能看出来。
最后,TATOOLS 把算法整理好的短条目交给另一个大语言模型写整体解读,包括弧型和三段对比,也包括高点低谷、转折点和情绪构成,每个转折都带着证据句。解读里对转折的解释要引用材料里的条目编号,【情绪走势解读】里的每一条说法都能追回到具体的位置和原文。
09
多份文本一起比较
每份文本都压成了 100 个点,长短不同的作品可以画在同一张图上。上传多份文件时,报告多出【多文件走势对比】,叠加各份文本的平滑曲线,并用一张表并排列出每份的弧型和主导情绪,效价与唤醒度的均值、效价波动和正负面占比,以及转折数。
10
在 TATOOLS 中生成情感曲线
打开 TATOOLS 的全文情感曲线工具页。下图展示工具页的默认设置,操作时可以沿页面从上往下完成。
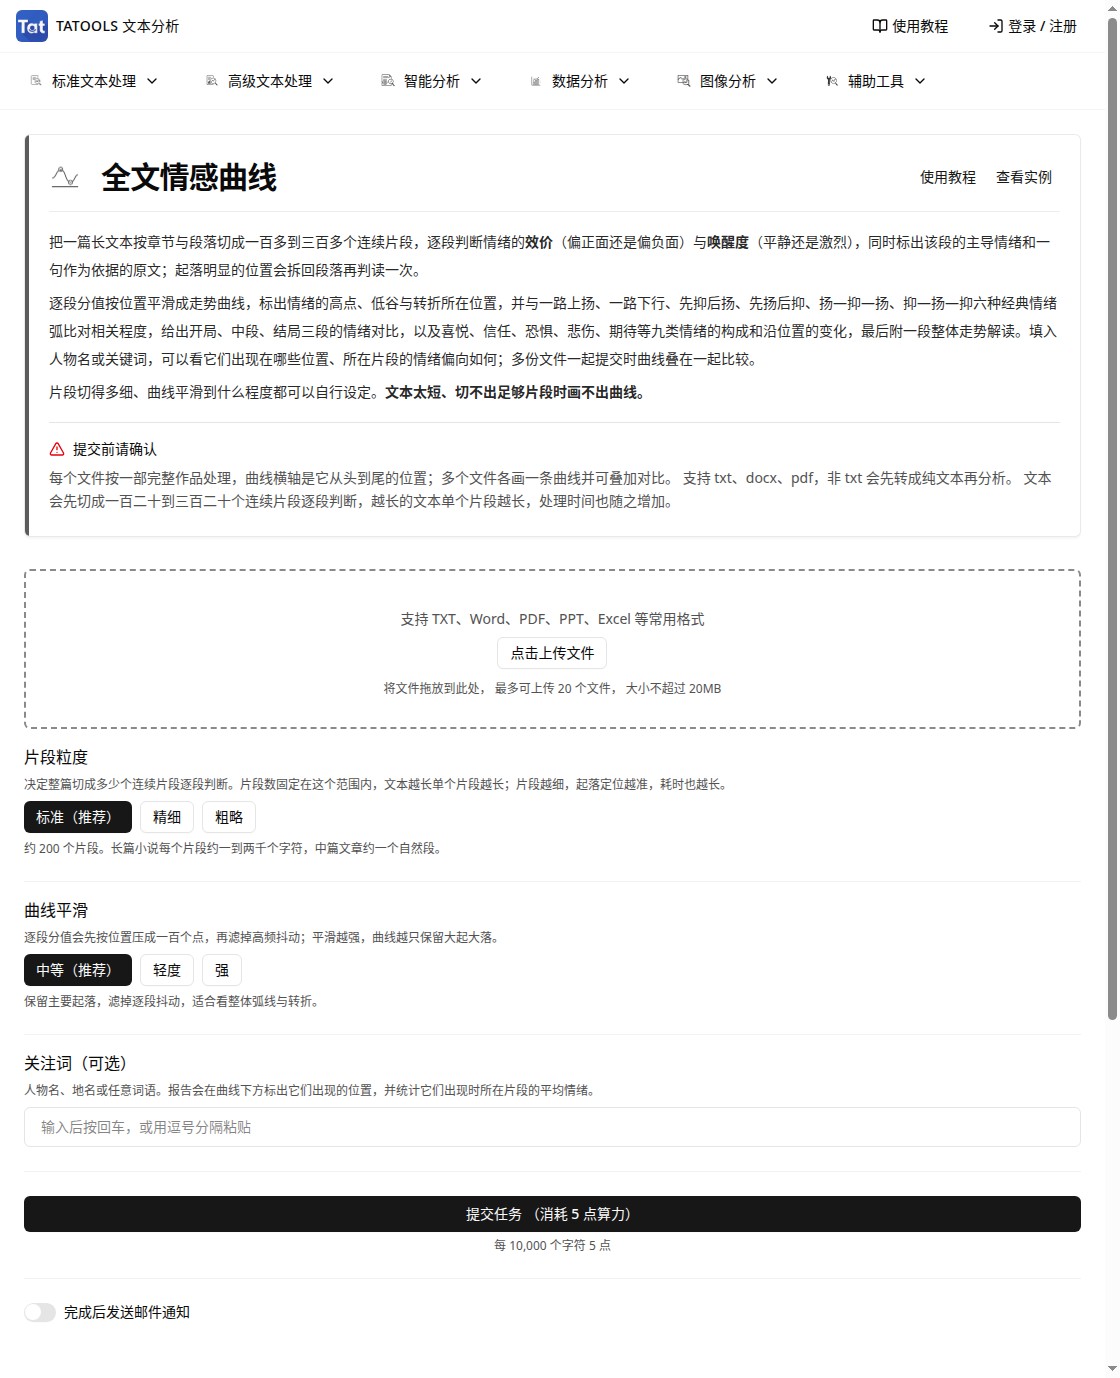
全文情感曲线工具页:上传文档、片段粒度、曲线平滑与关注词设置
操作步骤
上传文档。 每份文档放一部完整作品,保留原有叙述顺序。TATOOLS 按每份文本从头到尾的位置绘制曲线;比较几部作品时,把它们分别上传。
选择片段粒度。 第一次分析可保留【标准】。需要对照具体段落细看起落时选【精细】,只看整体走势时选【粗略】。这里改变的是逐段判断的切分粒度。
设置曲线平滑。 【中等】保留主要起落;【轻度】显示更多局部变化;【强】适合观察较大的波段。平滑设置决定报告曲线保留多少起伏。
按研究问题填写关注词。 要观察某个人物出场时的情绪,可以输入人物名并按回车;只研究全文走势时留空。报告会标出关注词出现的位置,并统计相关片段的平均情绪。
提交任务。 核对所选设置,点击页面下方的【提交任务】。需要邮件提醒时,先打开【完成后发送邮件通知】并填写邮箱。
打开报告。 处理完成后进入任务详情,先核对【任务描述】中的片段粒度和曲线平滑,再阅读结果。也可以从工具页右上角的【查看实例】打开下文使用的公开报告,先熟悉各区块。
设置一览
| 设置 | 选项 | 默认 | 影响什么 |
|---|---|---|---|
| 片段粒度 | 精细、标准、粗略 | 标准 | 切成多少个片段逐段判断 |
| 曲线平滑 | 轻度、中等、强 | 中等 | 曲线保留多少起伏 |
| 关注词 | 最多 30 个词 | 空 | 标出哪些词出现的位置 |
TATOOLS 把每个文件当作一部完整作品处理,曲线的横轴是它从头到尾的位置。
11
报告怎么读
下面使用 TATOOLS 现有的全文情感曲线公开实例说明读图方法。这份实例处理了 1 份文本,共 2590 个字符,使用【精细】片段粒度和【轻度】曲线平滑,关注词留空。上面的工具页截图展示默认的【标准】和【中等】;复现这份实例的设置时,需要分别切换。
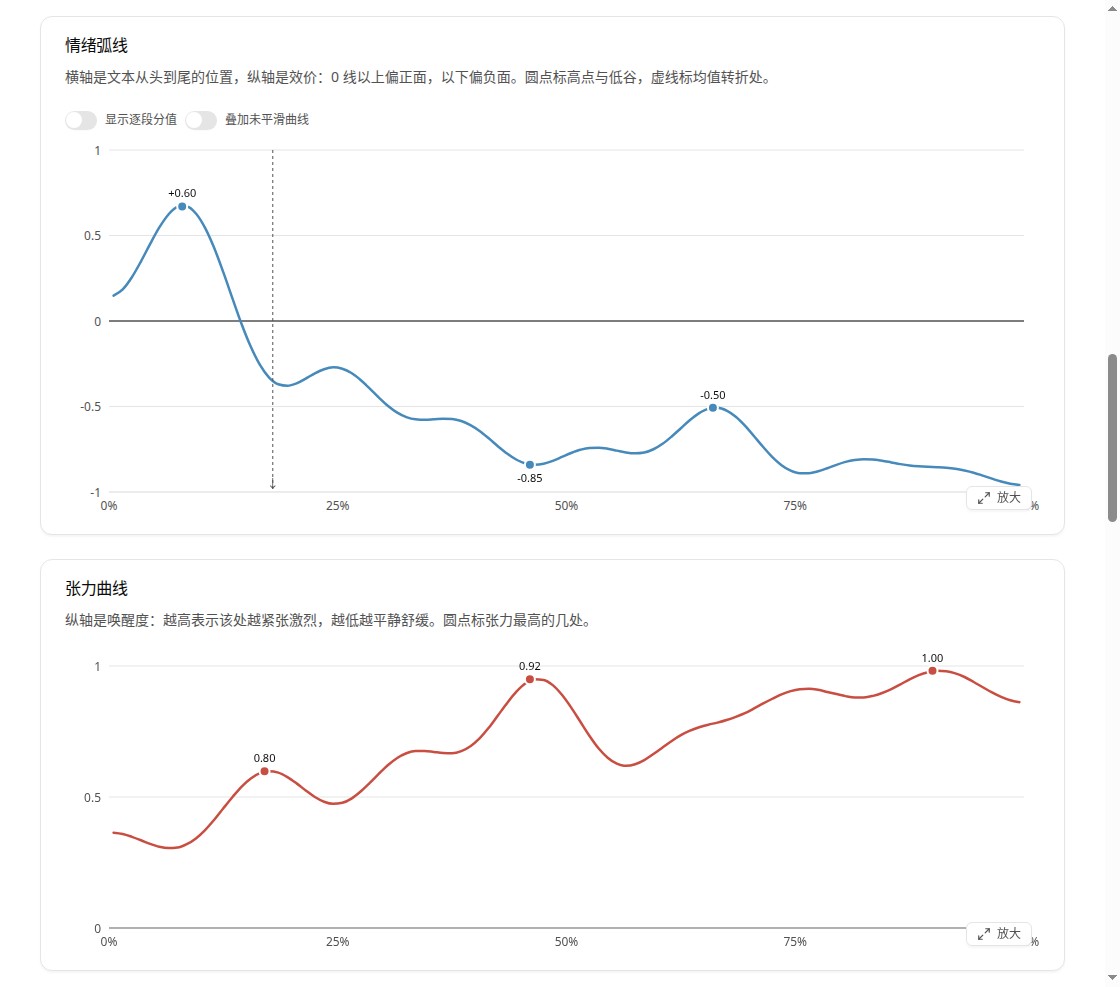
全文情感曲线公开实例报告中的情绪弧线与张力曲线
情绪弧线:情绪在什么位置转好或转坏
上半张图是【情绪弧线】。横轴把全文从开头到结尾表示为 0% 到 100%,50% 表示文本中部。纵轴是效价,范围为 −1 到 1;曲线在 0 线上方时偏正面,下方时偏负面。
实例中的蓝色曲线开头上升,随后落到 0 以下。后半段有一次短暂回升,接着再次下降。图上两个高点分别标注 +0.60 和 −0.50,低谷标注 −0.85。高点表示相对于附近区间的回升,所以标注 −0.50 的高点仍然处在负面区间。
圆点落在平滑曲线的高点或低谷处,旁边的数字取自关联原文片段的效价。全文约 18% 处的竖虚线标记均值转折,报告列出的转折前后效价均值为 +0.43 和 −0.67,显示这一位置前后的情绪基调由正转负。
图上方的【显示逐段分值】可以展开片段散点,查看局部判断;打开【叠加未平滑曲线】,可以比较平滑前后的走势。要读取某个片段的数值,结合散点或下方【片段明细】查看。
张力曲线:同一位置有多平静或激烈
下半张图是【张力曲线】,横轴与情绪弧线一致,纵轴为 0 到 1 的唤醒度。数值越高,表示该处越紧张激烈;越低则越平静舒缓。圆点标出张力高处,旁边的数字来自关联原文片段的唤醒度。
这份实例中,文本中段的效价落入低谷,同一带的张力升高,张力高点标注为 0.92。接近结尾时,红色曲线再次升高,另一处标注达到 1.00。把上下两图对齐,可以看出这些位置同时呈现负面效价和较高唤醒度,再回到原文寻找对应情节。
从曲线回到原文
在报告的【高点、低谷与转折】表中,找到想解释的位置,再点击这一行的【原文】。TATOOLS 会打开原文定位窗口,显示关联片段。图中的圆点和转折标记也可以点击。
例如,实例低谷关联的证据句是【我吓得一口气跑下十七楼,躲进房间里把门反锁】。读到这段原文后,就能把曲线上的负面效价与人物逃离、反锁房门的情节对上。写分析时,把位置、分值和对应原文放在一起,读者便能沿着同一条线索复核。
结合概况与明细解释整篇走势
【曲线概况】把这份实例归为【一路下行】,与该模板的相关系数为 0.83。这个数比较的是曲线形状。报告的【开局、中段、结局】给出的效价均值依次为 0.00、−0.68 和 −0.86,可以与上图由前向后的下降走势对照。
【情绪构成】进一步说明负面基调由哪些情绪组成。这份实例的恐惧占比为 84%,统计的是主导情绪被判为恐惧的片段所覆盖的字符,在全部有效片段字符中所占的比例。需要追踪某一段判断时,再到【片段明细】查看分值和证据。
报告中各区块的用途如下。
| 区块 | 先看什么 |
|---|---|
| 这份结果说明了什么 | 弧型、主要起落和整体基调 |
| 曲线概况 | 片段数、弧型及相似程度、整体效价与唤醒度 |
| 情绪走势解读 | 一段整体解读和每个转折的解释 |
| 情绪弧线 | 效价曲线、高点低谷和转折位置 |
| 张力曲线 | 唤醒度最高的几处 |
| 开局、中段、结局 | 三段的效价、唤醒度和主导情绪 |
| 情绪构成 | 九类情绪的占比和沿位置的变化 |
| 高点、低谷与转折 | 每一处的分值和证据句 |
| 关注词出现时的情绪 | 每个关注词的出现次数和平均情绪 |
| 片段明细 | 逐段分值、主导情绪和证据 |
阅读自己的报告时,可以沿用上面的顺序,把【曲线概况】与曲线位置对照,再用原文解释具体起落。填写过关注词的任务,还可以用【关注词出现时的情绪】查看相关片段。
TATOOLS 下载的结果里每份文本有两张表,一张是全部片段和细化子片段的逐段分值、主导情绪和证据,一张是 100 个点的平滑和原始曲线值。
12
把结果写进论文
下面是一段常见的写法示例,方括号里换成自己的内容。
本研究使用 TATOOLS 的全文情感曲线,将 [作品] 按章节与自然段切分为 [片段数] 个连续片段,逐段标注效价、唤醒度与主导情绪(Russell,1980;Plutchik,2001),并对情绪变化剧烈处细分重判。逐段效价按位置重采样为 100 点,经离散余弦变换低通平滑(Jockers,2015),以 PELT 算法检测转折点(Killick 等,2012),并与六种基本情绪弧(Reagan 等,2016)计算相关。结果显示,该作品的情绪曲线与 [弧型] 最为接近(r = [数值]),主要转折位于全文约 [位置]%。
论文里引用曲线时,写明片段粒度和平滑档位,并引用高点、低谷和转折处的原文证据,读者就能把曲线和文本对上。
13
小结
情绪用效价、唤醒度和支配度三个维度刻画,再从九类里选一个主导情绪。
全文按章节和自然段切成连续片段,在语义断裂处优先下刀,片段目标长度随全文字数变化。
逐段打分附原文证据,情绪变化剧烈处拆回自然段重判。
逐段分值压成 100 个点,离散余弦变换低通平滑,PELT 找出均值跳变的转折点。
平滑曲线和六种经典情绪弧计算相关,TATOOLS 再给出三段对比、情绪构成、关注词统计和整体解读。
想逐条给短文本打效价、唤醒度和支配度,可以用 TATOOLS 的【VAD 三维情感分析】;想逐条判断情感倾向并归纳消极原因,用【高级情感分析】。
14
资料来源
Russell:A Circumplex Model of Affect,Journal of Personality and Social Psychology,第 39 卷第 6 期,1980
Plutchik:The Nature of Emotions,American Scientist,第 89 卷第 4 期,2001
Jockers:syuzhet,Extracts Sentiment and Sentiment-Derived Plot Arcs from Text,CRAN,2015–2020
END