词频统计回答材料在谈什么,共词网络回答什么与什么相关,两者都停留在词的层面。知识图谱抽取把材料表示为实体之间带方向、带类型、带证据的关系网络,分析单位从词变成了关系。本教程分上下两篇:上篇讲一张图怎样从文本中建立起来,包括本体与抽取框架、两阶段抽取、证据锚定、实体消解、两种图口径、结构角色、多文档合图与基础报告的读法;下篇讲怎样在图上做网络分析、划分主题板块,以及追问系统怎样建立。
TATOOLS 的【知识图谱抽取】把这条链路做成一次任务:【上传文档】并选择抽取框架,就得到一张节点可点、边可筛、每条边都能回到原句的有向图。
01
关系才是分析单位
知识图谱(Knowledge Graph)在形式上是一张有向图 G = (V, E)。V 是实体集合,每个实体是材料中被谈论的对象:人物、机构、概念、事件、地点。E 是三元组集合,每条三元组写作 (h, r, t):h 是主体(head),r 是谓词(relation),t 是客体(tail)。三元组既有方向,也有类型,这是它与共词边的根本差别。
| 表示 | 分析单位 | 能回答的问题 |
|---|---|---|
| 词袋 | 词频 | 材料在谈什么 |
| 共词网络 | 词对共现次数 | 什么与什么相关 |
| 知识图谱 | 三元组 (h, r, t) | 谁以何种方式作用于谁 |
以原句【教育部于 2021 年印发双减政策】为例。词袋把它记为三个词的计数;共词网络在【教育部】与【双减政策】之间连一条无向边,记录它们同句出现;知识图谱则抽出三元组(教育部,印发,双减政策),方向从教育部指向政策,谓词说明作用方式。研究者关心的往往正是后者:谁发布了什么、哪个理论支持哪个结论、哪个受访者提到了哪种需求。
TATOOLS 报告中的三种基本单位与图元素一一对应:
| 单位 | 在图中 | 在报告中 |
|---|---|---|
| 实体 | 一个节点 | 【实体概览】 |
| 关系 | 一条有向边 | 【关系三元组】 |
| 证据 | 挂在边上的原文 | 【关系三元组】的【证据回溯】列 |
02
本体决定看见什么
本体(Ontology)规定一张图允许有哪些实体类型和关系类型。它是信息抽取的研究设计:同一批材料,用不同本体抽取,会得到回答不同问题的图。
信息抽取有两条路线。开放抽取(Open Information Extraction)不预设类型,凡是文本表达的关系都收进来,覆盖面广。模式引导抽取(Schema-guided Information Extraction)按预设的实体类目与关系谓词优先识别,结果更贴合研究问题,谓词也更整齐。TATOOLS 采用后者,并把本体做成工具页上的【抽取框架】。
| 框架 | 实体类目 | 关系谓词 | 适合的材料 |
|---|---|---|---|
| 通用知识图谱 | 人物、组织、地点、概念、事件 | 包含、影响、属于、使用 | 综合性文本 |
| 文献综述 | 理论、方法、变量、结论、文献 | 提出、验证、支持、扩展 | 一个领域的论文集 |
| 政策分析 | 主体、工具、目标、约束、指标 | 发布、要求、监管、协同 | 政策文件汇编 |
| 访谈材料 | 受访者、事件、需求、态度、资源 | 经历、评价、参与、需要 | 访谈转录稿 |
| 教材知识点 | 概念、原理、案例、阶段、场景 | 解释、依赖、对比、应用 | 教材与讲义 |
五个预设之外,【自定义框架】允许各输入最多 20 个实体类目与关系谓词;类目留空时沿用通用类目。框架是优先级而不是过滤器:它决定抽取时先关注什么,文本明确支持的框架外关系仍会保留为自由文本谓词。
同一批教育政策材料,用【政策分析】框架得到的是主体、工具、目标之间的网络;改用【通用知识图谱】框架,人物与事件会更多地进入图中。换框架就是换研究视角。
03
先找实体,再连关系
两阶段抽取(Two-stage Extraction)先在一段文本中识别实体,再只在这些实体之间判断关系。分开做有两个好处:关系抽取的候选空间从任意词对收缩到已识别的实体对,谓词也能对齐框架给出的类目。
全文按【分块大小】切成片段,片段内再按句子边界组成上下文窗口。
实体阶段:在窗口内识别人物、机构、概念、事件等实体,并对齐框架类目。
关系阶段:只在本窗口的实体之间抽取 (h, r, t),并保存一句原文作为证据。
全部窗口完成后,按名称把跨窗口出现的同名实体合并成一个节点。
一条关系的两端必须在同一个上下文窗口里同时出现,这是理解【分块大小】的关键。示例:第一章写【教育部印发双减政策】,第五章写【双减政策要求校外培训机构登记】。两条关系各自在所在窗口抽出,然后通过共同节点【双减政策】连成一条两跳链:教育部 → 双减政策 → 校外培训机构。跨窗口的连接依靠共同实体,而不依靠一次性的长距离抽取。
【分块大小】可在 1,000 至 10,000 字符之间设置。段落长、关系跨度大的材料用较大值,让相隔较远的实体进入同一窗口;结构紧凑、每段自成一事的材料用较小值即可。提交前把需要建立关系的对象组织在同一段落内,是提升抽取质量最直接的办法。
04
每条边都挂着证据
证据锚定(Evidence Grounding)要求每条三元组附带支持它的原文片段。它让抽取结果具备可审计性(Auditability):任何一个结论都能追溯到材料中的具体句子。这是知识图谱区别于手绘概念图、也区别于纯统计网络的方法论标准,也是研究者能在论文中引用抽取结果的前提。
| 关系字段 | 内容 | 在 TATOOLS 报告中 |
|---|---|---|
| 主体、谓词、客体 | 三元组本身 | 【关系三元组】表 |
| 证据 | 支持该关系的原文句 | 【证据回溯】列 |
| 来源文件 | 证据出自哪份材料 | 来源徽章 |
| 置信度 | 关系在网络中的突出程度 | 百分比列 |
示例:三元组(教育部,印发,双减政策)挂着证据【2021 年 7 月,教育部印发关于进一步减轻义务教育阶段学生作业负担和校外培训负担的意见】,来源文件为【政策汇编】。写进论文时,引用的是这句原文及其出处,三元组是它的结构化摘要。
同一关系在材料多处被陈述时,TATOOLS 保留多条去重后的证据;【关系三元组】表默认展示第一条,展开后可看到全部出处。核对一条关系时依次检查四件事:引文是否确实出现在材料中,主体和客体是否就是引文所指对象,谓词是否准确概括原文关系,箭头方向是否与原文陈述一致。
05
一个对象,一个节点
实体消解(Entity Resolution)把指向同一对象的不同写法归并为一个节点,并选出代表名(Canonical Name);谓词归一(Predicate Normalization)对关系类型做同样的事。没有这一步,同一对象会散成多个低连接度节点,后续的中心性、密度和板块划分都会系统性失真。
示例:三条关系(教育部,印发,双减政策)、(国家教育部,发布,双减文件)、(中华人民共和国教育部,颁布,双减)归并前是 6 个节点、3 条互不相连的边;归并后是 2 个节点,三条陈述汇成同一对实体之间的关系,【教育部】不再分散成三个节点。
| 环节 | TATOOLS 的做法 |
|---|---|
| 自动归并 | 【聚类优化】默认开启,抽取完成后先归并实体名,再归并谓词 |
| 归并原则 | 只合并明确指向同一对象或同一关系的写法 |
| 结果透明 | 【聚类合并详情】列出每组代表名与全部别名 |
| 人工补充 | 【手动合并同义实体】在报告中勾选实体、指定代表 |
| 版本保留 | 提交后生成新版本报告,原版本不变,两版可并排比较 |
自动归并采用保守策略:把握不足的写法保留为独立节点,交由研究者在【手动合并同义实体】中决定。手动合并只做数据变换:名称替换、平行边合并、统计重算,不重新抽取,关系的方向、谓词和证据一条不动。
06
一张图,两种口径
同一批三元组可以建成两种图,报告中的不同区块使用不同的图。
有向多重图(Directed Multigraph)保留每条三元组:同一对实体之间可以有多条不同谓词的边,两个方向分别计数。无向简单图(Undirected Simple Graph)把同一对实体之间的全部关系合并为一条边,忽略方向,去掉自环,边权等于这对实体之间全部关系的证据条数。
有向多重图密度 D1 = m / [n(n−1)]
无向简单图密度 D2 = 2m' / [n(n−1)]
n 实体数 m 三元组数 m' 合并后的边数
示例:20 个实体、30 条三元组,其中两对实体各有 2 条关系,合并后得到 28 条边。有向密度 D1 = 30 ÷ 380 = 7.9%,无向密度 D2 = 56 ÷ 380 = 14.7%。两个数都对,但口径不同。
| 使用有向多重图 | 使用无向简单图 |
|---|---|
| 力导图、【关系三元组】 | 【网络结构指标】 |
| 【关系谓词分布】【节点连接度排名】 | 主题板块与模块度 |
| 【知识图谱深度分析】、GraphML 导出 | 论文中报告的网络指标 |
TATOOLS 的两张卡分别标注口径。论文报告密度、中心性和模块度时,从【网络结构指标】卡取数,并写明无向简单图、边权为证据条数。导出的 GraphML 保存有向多重图,在 Gephi 等软件中直接重算得到的是【知识图谱深度分析】的口径。
07
位置决定角色
在有向图中,实体作为主体出现的次数是出度(Out-degree),作为客体出现的次数是入度(In-degree),两者之和是连接度(Degree)。结构角色(Structural Role)只由这两个数决定,与实体类型无关。
| 角色 | 判定 | 读法 |
|---|---|---|
| 核心实体 | 连接度显著高于全图平均 | 材料反复围绕的对象 |
| 主体 | 出度明显高于入度 | 主要作为行动者出现 |
| 客体 | 入度明显高于出度 | 主要作为被作用对象 |
| 关联实体 | 出入度相当 | 承接与发出兼有 |
| 独立实体 | 连接度为 0 | 被提及但未建立关系 |
判定顺序固定:先看是否孤立,再看是否核心,最后比较主客体方向。核心门槛取全图平均连接度的 1.5 倍与 3 中的较大者。示例:【教育部】出度 5、入度 0,是主体;【校外培训机构】出度 0、入度 4,是客体;【双减政策】出度 3、入度 2,是关联实体;若全图平均连接度为 2,三者都达到核心门槛。
【关系三元组】里的置信度衡量一条关系在网络中的突出程度,由谓词频次与两端实体的连接度合成:谓词越常见、两端越活跃,数值越高,取值在 50% 至 100% 之间。它回答【这条关系在整张图里有多显眼】;一条关系是否成立,回到【证据回溯】核对原文。TATOOLS 的【实体概览】按连接度排序并标注角色,【节点连接度排名】给出每个实体的连接度占比。
08
多份材料合成一张图
跨文档实体链接(Cross-document Entity Linking)把不同文件里的同名对象连到同一节点,让分散在多份材料中的陈述汇成一张网。政策汇编、访谈集、文献集都是天然的多文档语料。
TATOOLS 的【上传文档】可以一次提交多份材料,它们进入同一轮抽取,每条关系记录来源文件,报告中的来源徽章显示一条关系出自哪份材料。
| 研究设计 | 做法 | 得到什么 |
|---|---|---|
| 汇总视角 | 全部文件合成一张图 | 跨文件的共同行动者与议题 |
| 比较视角 | 每份文件单独提交 | 各自的网络指标可并列比较 |
| 追踪视角 | 按时期分批提交 | 同一实体在不同阶段的连接变化 |
示例:三份年度政策文件合图后,【教育部】在三份文件里都作为主体出现,连接度是单文件的三倍;只在某一年出现的【课后服务】只连着那一年的关系,来源徽章能直接看出。需要比较各文件时,用比较视角分别提交,再把各自的【网络结构指标】并列。
09
四类材料,四种研究设计
| 材料 | 框架与网络 | 能回答的问题 |
|---|---|---|
| 几百份政策文件 | 政策分析:主体、工具、目标、指标 | 谁用什么工具追求什么目标 |
| 一个领域几十篇论文 | 文献综述:理论、方法、变量、结论 | 哪些理论支撑哪些结论 |
| 几十份访谈稿 | 访谈材料:受访者、事件、需求、态度 | 哪些需求被反复提及 |
| 一本教材 | 教材知识点:概念、原理、案例、场景 | 概念之间怎样依赖 |
提交前的材料准备决定图的质量:让需要建立关系的对象出现在同一段落,删除目录、页码和只含名称的并列清单,正文保持完整句子。程序不做分词、去停用词或清洗,材料原样进入抽取。
相同文件与相同设置的重复提交直接复用已完成的结果。比较两次任务时,记录文件顺序、框架、【分块大小】与【聚类优化】开关,即可完整复现。
10
基础报告怎样读
【统计概要】:实体数、关系数、谓词种类与合并组数,一屏总览。
力导图:节点大小按连接度,可拖拽缩放;【前 N 个主题】滑块按连接度保留最重要的实体及其直接关联。
【实体概览】:名称、角色、连接度、同簇实体,可排序。
【关系三元组】:主体、谓词、客体、置信度、证据与来源,复核关系的主要入口。
【关系谓词分布】:每种谓词的次数与占比,分母是关系总数。
【节点连接度排名】:每个实体的连接度占比;每条关系同时计入两端,所以全部占比之和为 200%。
【关键词锚定】:输入关键词,按包含匹配定位命中的实体与关系。
| 导出表格 | 内容 |
|---|---|
| nodes | 实体、角色、同簇实体 |
| relationships | 三元组、置信度、证据、来源文件 |
| cluster_merges | 代表实体与被合并的别名 |
| edge_type_distribution | 每种谓词的出现次数 |
| metadata | 实体数、关系数等统计 |
导出表格与报告字段一一对应,GraphML 网络文件可直接导入 Gephi、yEd、Cytoscape。
11
用一份街道意象材料走完抽取
打开知识图谱,在【上传文档】放入材料。当前任务页提供【抽取框架】、【分块大小】与【聚类优化】;选好框架后,点【提交任务】,完成后打开报告。下面两张任务页截图记录的是当前入口和设置区。公开实例实际使用【通用知识图谱】框架、6000 字符分块,并开启了【聚类优化】;截图中的当前默认状态不能代替实例的历史设置。
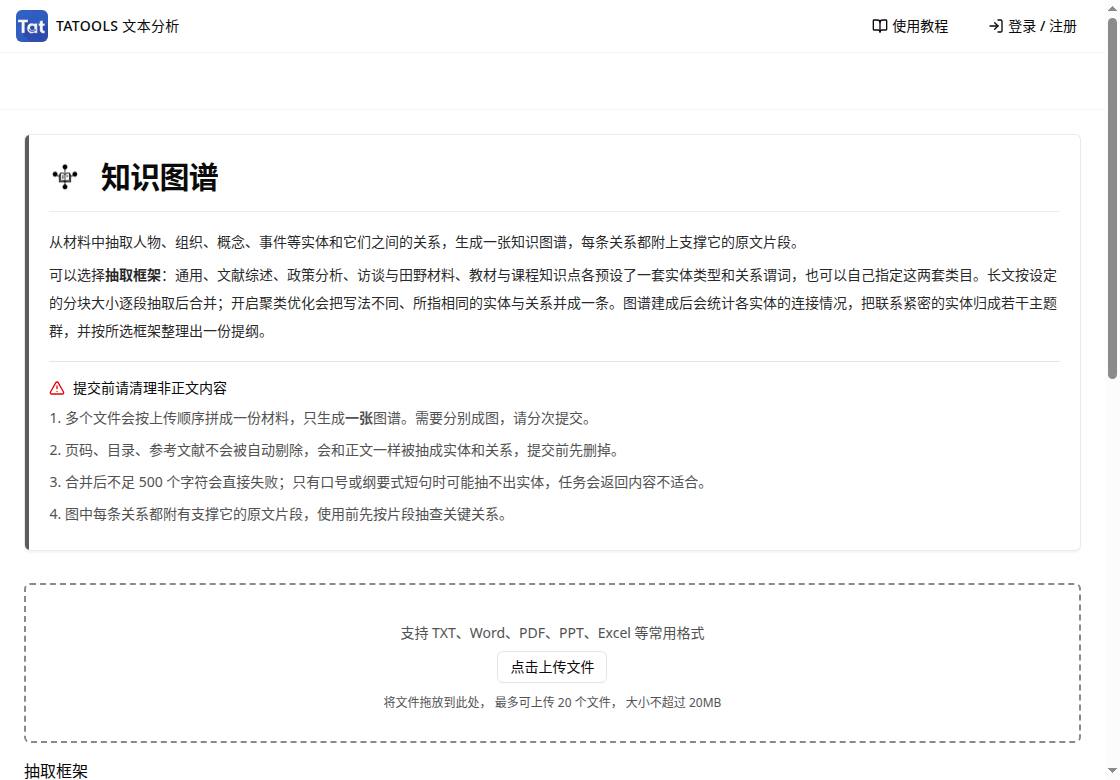
知识图谱任务页的功能介绍与上传文档入口
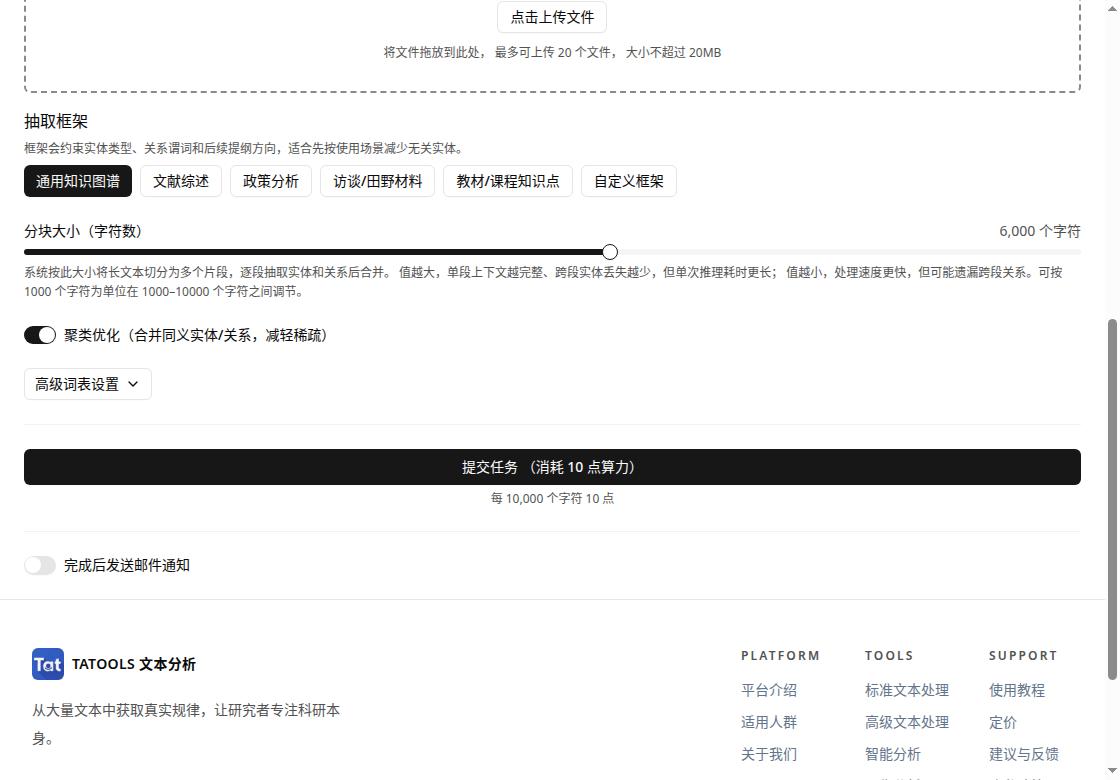
知识图谱任务页的抽取框架、分块大小、聚类优化与提交入口
下面使用街道意象成因研究公开实例。材料讨论南锣鼓巷的街道意象。报告记录本次从材料中抽取了 179 个实体、104 条关系,并把实体分成 104 个互不连通的子域,最大子域有 69 个实体。另有 100 个实体没有关系连接。这些数字描述本次抽取形成的图。
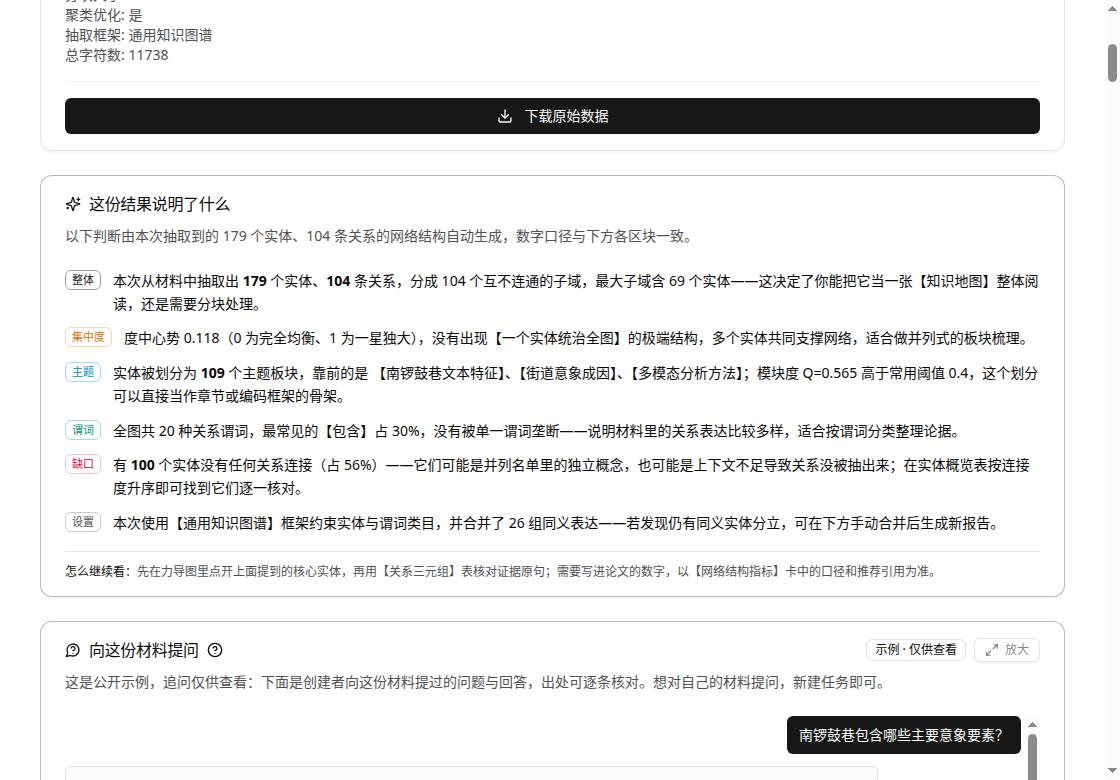
街道意象成因研究实例的抽取结果说明
报告顶部还列出 20 种关系谓词,【包含】占关系的 30%。往下读【关系三元组】时,先看主体、谓词与客体,再核对每条关系所附的原文证据和来源。需要保存逐条结果,可使用报告的【下载原始数据】;网络指标的分母和读法在下篇展开。
12
上篇小结
知识图谱把分析单位从词提升为带方向、带类型的三元组。
抽取框架是研究设计:五个预设本体或自定义类目决定图回答谁的问题。
两阶段抽取先识实体再连关系,一条关系的两端必须同处一个上下文窗口。
每条边都挂着原文证据与来源文件,结果可审计、可引用。
实体消解与谓词归一自动完成且全程透明,手动合并生成新版本。
有向多重图与无向简单图两种口径分别标注,论文取数用后者。
结构角色由出度与入度决定,置信度标出关系在网络中的突出程度。
下篇讲网络结构指标、三种中心性与中心势、社区发现与模块度、推理链,以及追问系统怎样建立。
13
资料来源
Ji 等:A Survey on Knowledge Graphs: Representation, Acquisition, and Applications,IEEE TNNLS,2022
Niklaus 等:A Survey on Open Information Extraction,COLING,2018
END