上篇讲了一张图怎样从文本中建立起来。下篇回答图能推出什么:整体结构上材料有多紧凑、是否连成一片、围绕谁组织;局部位置上谁是中心、谁是桥梁、谁自成一派;语义层面上某个关系在材料里究竟怎么说。前四层来自社会网络分析(Social Network Analysis),第五层来自检索增强生成。TATOOLS 在无向简单图上计算全部网络指标,每项附解读句与推荐文献,并为每份材料建立可追问的索引。
01
从图到结论的三层
| 层次 | 方法 | TATOOLS 区块 |
|---|---|---|
| 整体结构 | 密度、平均度、聚类系数、连通分量 | 【网络结构指标】 |
| 局部位置 | 度、接近、中介三种中心性与中心势 | 【网络结构指标】标签页 |
| 分群 | 社区发现、模块度 | 【主题板块】 |
| 路径 | 推理链、最短路径 | 【知识图谱深度分析】【实体关系速查】 |
| 语义 | 检索增强问答 | 【向这份材料提问】 |
网络指标的标准参考是 Wasserman 与 Faust 1994 年的教材;中心性框架来自 Freeman;社区划分来自 Newman 的模块度与 Traag 等人的 Leiden 算法。下文逐层展开,每层给出定义、公式、可手算的示例与报告中的位置。
02
密度、平均度与聚类系数
密度 D = 2m / [n(n−1)]
平均度 k = 2m / n
聚类系数 C = 3 × 三角形数 / 连通三元组数
n 实体数 m 边数(无向简单图)
密度是实际边数占所有可能边数的比例,回答材料有多紧凑。平均度是每个实体平均连几条边,回答实体是否反复出现在不同陈述里。聚类系数是一个实体的邻居之间也互相连接的比例,回答实体是否抱团成小圈子;Watts 与 Strogatz 1998 年用它刻画小世界网络。
示例:20 个实体、28 条边,D = 56 ÷ 380 = 14.7%,k = 2.8。若某实体有 4 个邻居,邻居之间有 2 条边,它的局部聚类系数为 2 ÷ 6 = 0.33;全图聚类系数取各实体局部值的平均。
| 指标 | 高值的含义 | 低值的含义 |
|---|---|---|
| 密度 | 材料集中讨论少数对象 | 材料涉及面广、陈述分散 |
| 平均度 | 实体在多处被反复陈述 | 多数实体只出现一次 |
| 聚类系数 | 实体形成紧密小团体 | 关系呈树状或星状展开 |
密度随规模缩小:实体越多,可能的边数按平方增长,实际边数按线性增长。比较不同规模的图时用平均度,不用密度。TATOOLS 的【网络结构指标】卡直接给出三项数值,解读句按文本抽取网络的常见区间写成:密度 0.5% 至 5% 为常见区间,平均度高于 2 表示多数实体不止出现在一条陈述里,聚类系数高于密度的 3 倍表示实体倾向抱团。
03
连通分量、路径与直径
连通分量(Connected Component)是彼此可达的最大实体集合;最大分量(Giant Component)的占比说明材料是否讲的是一件事。平均路径长度 L 是最大分量内任意两实体最短路径的平均步数;直径 d 是最远两实体的步数。
| 指标 | 含义 | 读法 |
|---|---|---|
| 连通分量数 | 互不相连的子网个数 | 多说明材料讨论几件独立的事 |
| 最大分量占比 | 最大子网实体数 ÷ 实体数 | 高说明材料有统一主线 |
| 孤立实体 | 连接度为 0 的实体 | 被提及但未建立关系 |
| 平均路径长度 L | 任意两实体的平均步数 | 短说明关系传递快 |
| 直径 d | 最远两实体的步数 | 网络的跨度 |
示例:20 个实体分成 3 个分量,最大分量 16 个,占 80%;分量内 L = 2.4、d = 5,意味着多数实体之间只隔两步,最远的也不过五步。
TATOOLS 在【网络结构指标】给出分量数、最大分量实体数与孤立实体数,L 与 d 在最大分量上计算。【这份结果说明了什么】卡据此写出材料是一张完整网络还是分成几个子域,并给出孤立实体的数量与占比。
04
三种中心性
度中心性 C_D(v) = deg(v) / (n−1)
接近中心性 C_C(v) = (n−1) / Σ d(v,u)
中介中心性 C_B(v) = Σ σ_st(v) / σ_st
deg(v) 是 v 的连接度;d(v,u) 是 v 到 u 的最短距离;σ_st 是 s 到 t 的最短路径条数,σ_st(v) 是其中经过 v 的条数。Freeman 在 1979 年把三者统一为一套框架,各自回答不同的问题。
| 中心性 | 回答的问题 | 典型发现 |
|---|---|---|
| 度 | 谁直接连接最多 | 被提及最多的行动者 |
| 接近 | 谁离所有实体都最近 | 信息最容易到达的节点 |
| 中介 | 谁站在最多最短路径上 | 连接不同群体的桥梁 |
示例:星形网络的中心点 C_D = 1,其余各点 C_D = 1 ÷ (n−1)。两个团体之间唯一的连接点,度中心性可能很低,中介中心性却最高,它就是材料里的桥梁人物;在政策网络里,这常是同时出现在多个部门文件中的协调机构。
TATOOLS 为三种中心性各设一个标签页,列出前 10 个实体。接近中心性采用 Wasserman–Faust 修正处理不连通图:以可达实体数占比加权,使不同分量的实体可以比较。中介中心性在最大连通分量上归一化;实体超过 2,000 个时改用抽样近似,方法说明会注明本次是否抽样。导出的 centrality 表包含全部实体的三种中心性。
05
中心势:网络围绕谁
中心势(Centralization)把节点层面的中心性推广为整张图的一个数,回答材料是围绕少数行动者组织,还是多中心并立。Freeman 公式以度中心势为例:
C = Σ [C_D(v*) − C_D(v)] / [(n−1)(n−2)]
v* 为中心性最高的实体
取值 0 到 1:0 表示所有实体连接度相同,1 表示一个实体连接其余全部、而其余实体互不相连。
示例:5 个实体的星形,中心连接度 4,其余各 1,分子 (4−1)×4 = 12,分母 4×3 = 12,C = 1。5 个实体的环,人人连接度 2,C = 0。
| 中心势 | 网络形态 | 材料的可能样貌 |
|---|---|---|
| 接近 1 | 星形,围绕一个核心 | 一个机构主导全部陈述 |
| 中等 | 几个核心并立 | 多个行动者各有势力范围 |
| 接近 0 | 均匀,无明显核心 | 陈述分散,缺少主线 |
TATOOLS 在每种中心性下各给一行中心势。【这份结果说明了什么】卡以度中心势 0.4 为参照:达到 0.4 写围绕少数实体集中,否则写由多实体共同支撑。
06
社区发现与模块度
社区发现(Community Detection)在网络里找出内部连接紧密、彼此连接稀疏的板块。模块度 Q(Modularity)衡量一种划分的好坏:
Q = (1/2m) Σ [A_ij − k_i k_j / 2m] δ(c_i, c_j)
A_ij 是实体 i、j 之间的边权,k 是连接度,δ 在两者同板块时为 1。Q 比较板块内的实际边数与随机连接的预期边数,越高板块越分明。Leiden 算法是 Louvain 的改进,保证每个板块内部连通,同一张图重复计算得到相同划分。
| 对照 | 主题模型 | 主题板块 |
|---|---|---|
| 分组单位 | 词 | 实体 |
| 分组依据 | 词在文档中共现 | 实体之间有关系 |
| 产出 | 主题词表 | 板块名、摘要、核心实体 |
TATOOLS 在无向加权图上用 Leiden 划分【主题板块】,按实体数从大到小编号;实体数达到 3 个的板块依据其核心实体、代表关系与证据自动生成不超过 8 个字的板块名和一段摘要,不足 3 个的归入【零散实体】。板块在力导图上以色块条呈现,点击一个板块只保留它的实体与内部关系,再点一次恢复全图,选中后显示摘要和核心实体。页面以 Q = 0.4 为参照:高于它可把板块当作材料的议题结构来写,低于它把板块当作粗略分组线索。
07
推理链与实体速查
知识图谱是有向图,从一个实体沿箭头连续走下去得到一条有向路径(Directed Path);k 跳路径揭示 k 步之外的间接关系。最短路径(Shortest Path)回答两个实体之间最少经过几步、经过谁。
示例:教育部 →印发→ 双减政策 →要求→ 校外培训机构 →登记→ 主管部门,是一条 3 跳推理链。【教育部】与【主管部门】在原文里从未同句出现,图上却有了一条可逐跳核对的线索。
| 能力 | 内容 | TATOOLS 区块 |
|---|---|---|
| 最长推理链 | 从连接度最高的实体出发的最长有向路径,最多 5 步 | 【知识图谱深度分析】 |
| 间接关系链 | 两跳链 | 【知识图谱深度分析】 |
| 信息枢纽 | 邻居角色种类达到 2 种的实体 | 【知识图谱深度分析】 |
| 单实体速查 | 它是什么实体、直接关联了谁、有没有同义表达、常见关系类型、可推导哪些间接关系 | 【实体关系速查】 |
| 双实体对比 | 是否直接相连、共同关联、最短路径 | 【实体关系速查】 |
【实体关系速查】只查询已经建好的图,即时返回,不消耗算力。最短路径不区分方向,最多找 5 跳;找不到时提示两者可能属于不同子域。推理链是一条有向路径,每一跳都对应一条带证据的三元组,可逐跳回到原文。
08
深度分析卡与自动文字
【知识图谱深度分析】卡按有向多重图计算,四个方块分别是网络密度、平均连接度、知识子域和关系类型。右上角的【综合评分】由五个 0 至 100 的分数加权得到:
| 维度 | 含义 | 权重 |
|---|---|---|
| 密度 | 边够不够多 | 0.15 |
| 连通性 | 最大连通分量占比 | 0.25 |
| 关系多样性 | 谓词种类数 | 0.20 |
| 推理深度 | 最长有向链步数 | 0.20 |
| 覆盖度 | 非孤立实体占比 | 0.20 |
五个维度描述图的形状:边够不够多、连成一片还是几片、谓词种类多不多、顺着箭头能走多远、有多少实体没有关系。它是一张图的结构画像,关系是否成立仍以证据为准。
报告中还有三段自动生成的文字,都以图谱摘要为输入。【工作提纲】按框架命名,例如【文献综述提纲】【政策分析提纲】,依据连接度最高的实体与关系写 4 至 6 个小节。【要点速览】位于【实体关系速查】卡底部,列出 6 至 8 条问答并附适用场景。【图谱质量诊断】围绕实体覆盖度、关系粒度、连通性与改写建议展开。三段文字中的每个判断都能对回【关系三元组】表中的某条关系。
09
追问系统怎样建立
检索增强生成(Retrieval-Augmented Generation,RAG)先从材料中检索相关段落,再只依据这些段落作答,每句结论都能指回出处。图增强检索(GraphRAG)进一步把图谱里的三元组作为已知事实一并交给回答环节。TATOOLS 的【向这份材料提问】把两者结合。
索引在任务完成时建立,分三层:
| 索引层 | 内容 | 作用 |
|---|---|---|
| 段落向量索引 | 原文按句末标点切段,每段一条语义向量并记录来源文件 | 按语义找相关原文 |
| 实体向量索引 | 每个实体名一条语义向量 | 把问题里的说法对到实体 |
| 实体—段落倒排索引 | 实体名与同簇别名在哪些段落出现 | 命中实体后直取原文 |
语义向量(Embedding)把一句话映射为高维空间中的一个点,意思相近的句子距离相近,因此换一种说法也能找到对应段落。倒排索引则保证只要问题点到实体名,它所在的段落一定被取到。
索引只建一次,随任务保存。手动合并生成新版本时,实体表按合并结果重映射,追问在新版本上继续可用。
10
一次提问的四步
识别问题中的实体:先做实体名与别名的包含匹配和长名称的部分重合,再用向量相似度补足换了说法的实体。
取命中实体的直接关系作为已知事实。
混合检索段落:先取命中实体名下的段落,再按语义相似度补足;材料来自多份文件时扩大覆盖,使回答能引用多个来源。
受限生成:只依据检索到的段落与已知事实作答,第一句给结论,用方括号编号标出每句的原文出处。
| 问法 | 为什么有效 |
|---|---|
| 直接写实体名 | 走实体索引,命中最准 |
| 问两个实体的关系 | 已知事实里就有三元组 |
| 问某机构做了什么 | 实体名下的段落一次取齐 |
材料里没有的信息会直接说明没有;每次提问相互独立,问题里不用它、这个之类的指代。回答与编号出处并排显示,点编号即回到原文段。追问对任务创建者开放,要求任务已完成并在完成时建好索引;对话历史按版本保存。
11
版本、导出与论文写法
手动合并生成的新版本只做数据变换:名称替换、平行边合并、【统计概要】与【网络结构指标】重算、追问索引重映射,不重新抽取,原版本保留。新版本的【聚类合并详情】注明来自上一版手动合并的组数,新版本仍可继续合并,形成版本链。
| 导出 | 内容 | 用途 |
|---|---|---|
| graph_metrics | 全部指标及计算口径与参数 | 论文方法与结果 |
| centrality | 每个实体的度、接近、中介中心性 | 附表或进一步统计 |
| citations | 每项指标的推荐文献与模型辅助抽取披露 | 参考文献 |
| domain_insights | 【统计概要】中的摘要条目 | 结果描述 |
| GraphML | 有向图,节点带名称与角色,边带谓词与置信度 | Gephi、yEd、Cytoscape |
论文写法:从【网络结构指标】卡取实体数、边数、密度、平均度、聚类系数、连通分量、三种中心性与模块度,并写明口径:无向简单图、边权为证据条数、密度不计边权、接近中心性经 Wasserman–Faust 修正、中介中心性在最大分量上归一化并注明是否抽样。实体与关系由模型辅助抽取,方法部分说明所用框架类目。
TATOOLS 的【方法说明与推荐引用】为每项指标给出推荐文献和平台引用句式,一键复制进方法部分;导出的 citations 表包含大语言模型辅助抽取的披露参考。
12
对照公开实例读网络指标
打开 TATOOLS 的知识图谱,在【上传文档】放入材料,选择【抽取框架】,调整【分块大小】和【聚类优化】,再点【提交任务】。下图是当前任务页的入口与设置区。这里继续使用街道意象成因研究公开实例,实例当时选择【通用知识图谱】、6000 字符分块和【聚类优化】。
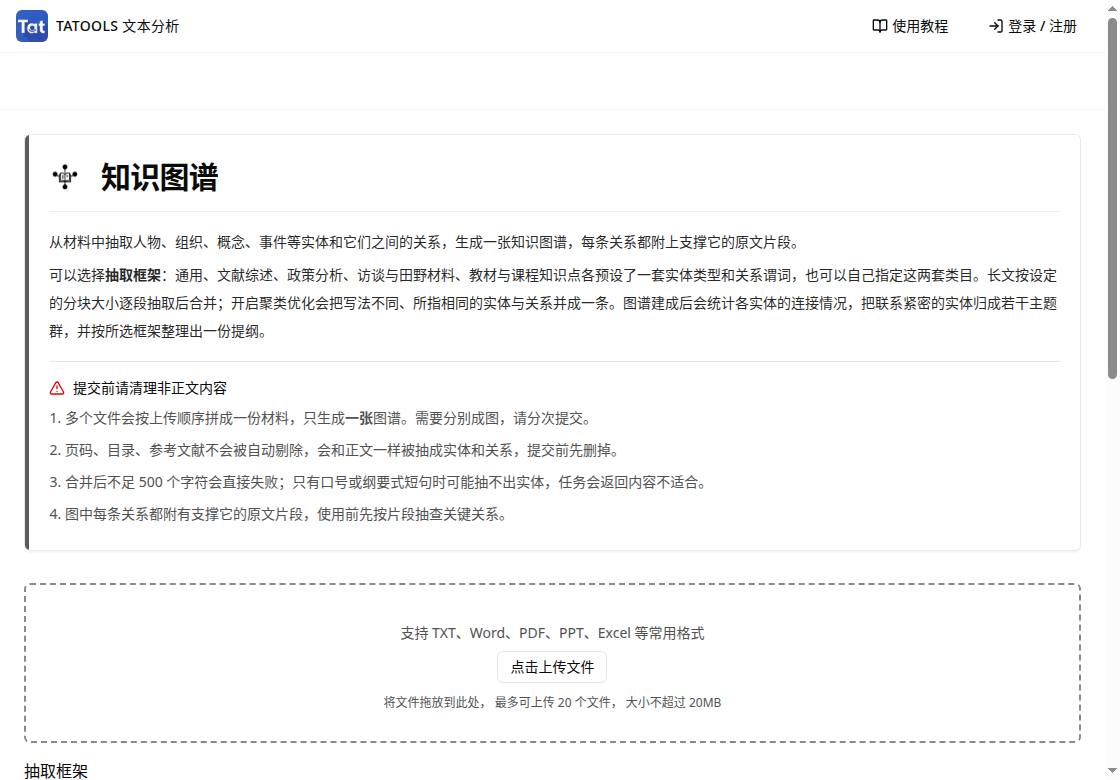
知识图谱任务页的功能介绍与上传文档入口
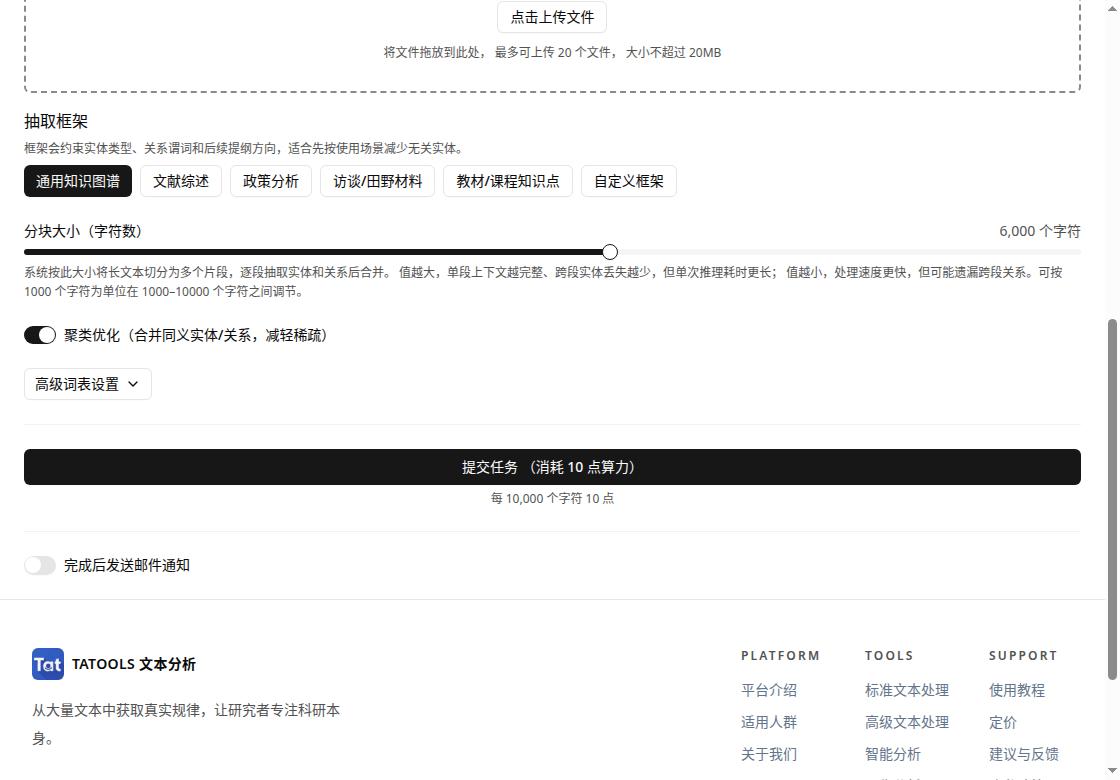
知识图谱任务页的抽取框架、分块大小、聚类优化与提交入口
实例报告抽取出 179 个实体与 104 条关系。打开【网络结构指标】可见网络密度 0.65%、平均度 1.16、聚类系数 0.025、模块度 Q 为 0.565,连通分量为 104 个,最大的分量含 69 个实体。这里的密度按无向简单图计算,104 条并边相对于 179 个实体之间所有可能的连接,占 0.65%。剔除 100 个孤立实体后,报告另列出 3.38% 的密度;两者使用的实体集合不同。
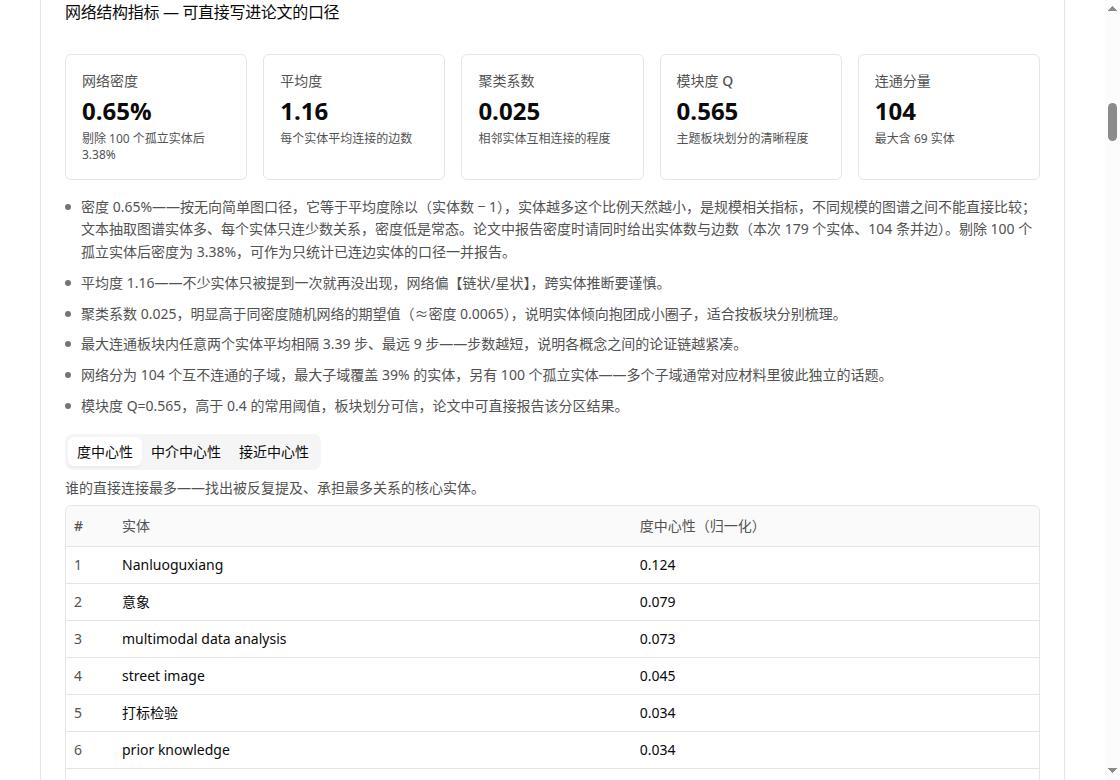
街道意象成因研究实例的网络结构指标与实体连接度排名
下方【度中心性】表把实体按直接连接数排序。截图中的首项是 Nanluoguxiang;它的归一化度中心性为 0.124。若要在论文中报告网络结构,可从这张卡取实体数、关系数和指标口径,并到【关系三元组】核对涉及的原文证据。报告顶部有【下载原始数据】入口。
13
下篇小结
密度、平均度、聚类系数刻画整体结构,比较不同规模的图用平均度。
连通分量与最大分量占比说明材料是一件事还是几件事,L 与 d 说明网络的跨度。
三种中心性分别找出被提及最多者、信息最易到达者与桥梁,中心势把它们压成整张图的一个数。
Leiden 划分主题板块,模块度 Q 说明划分是否清晰,板块自动命名并可点击筛选。
推理链与实体速查在图上走路径,追问系统靠三层索引把问题带回原文并给出编号出处。
版本、导出与推荐引用把结果按正确口径带进论文。
14
资料来源
Freeman:Centrality in Social Networks: Conceptual Clarification,Social Networks,1979
Freeman:A Set of Measures of Centrality Based on Betweenness,Sociometry,1977
Wasserman、Faust:Social Network Analysis: Methods and Applications,Cambridge University Press,1994
Watts、Strogatz:Collective Dynamics of Small-World Networks,Nature,1998
Newman:Modularity and Community Structure in Networks,PNAS,2006
Lewis 等:Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks,NeurIPS,2020
Edge 等:From Local to Global: A Graph RAG Approach to Query-Focused Summarization,2024
END